BMAD 和 OpenSpec 都想解决同一件事,AI 写代码时需求只活在聊天记录里。BMAD 用一套可伸缩的规划、构建与审查流程,把产品、架构、开发等视角请到桌边;OpenSpec 用一层轻量规格,把每一次变更讲清楚、记下来。本文结合我用 BMAD 从零做 ec-calc、日常用 OpenSpec 改代码的经历,补上两者到 BMAD v6.12 / v7 预览、OpenSpec v1.14 的最新变化,顺带看看 GitHub 的 Spec Kit,讲清它们的区别、成本,以及什么场景该选哪一个。
我用 AI 写代码,前后试过两套办法。它们在项目里留下的痕迹很好认,一个是 _bmad-output/,一个是 openspec/。
两个文件夹里装的都是 Markdown,都是写给 AI 看的。打开一看,气质却完全不一样。
_bmad-output/ 里有 PRD、架构文档、UX 规范、Epic 列表,还有一沓 Story 文件,像一家小公司的共享盘。openspec/ 里只有两个目录,一个写系统现在什么样,一个写这次打算改什么,像一本随手记的施工日志。
我之前分开写过这两个工具。这一篇不再把每条命令重新讲一遍,只想把它们摆在一张桌子上,聊聊它们到底差在哪,什么时候该用哪一个。顺便把这两个项目最近的变化补上,它们都变了不少。
同一个病根
先说它们为什么会长得这么像。
和 AI 结对写代码,最磨人的往往不是写代码本身。你花两段话描述一个功能,AI 听起来像懂了,写出来却跑偏。纠偏几轮,上下文窗口已经用掉大半。好不容易做完一个功能,第二天开个新对话,昨天定下的技术栈、约束和取舍,全没了,又得从头交代。
需求只活在聊天记录里,对话一关,一切归零。
BMAD 和 OpenSpec 开出的药方,方向是一致的,把重要的东西写成文件,放进仓库。AI 每次开工,从文件出发,不从你的口头描述出发。
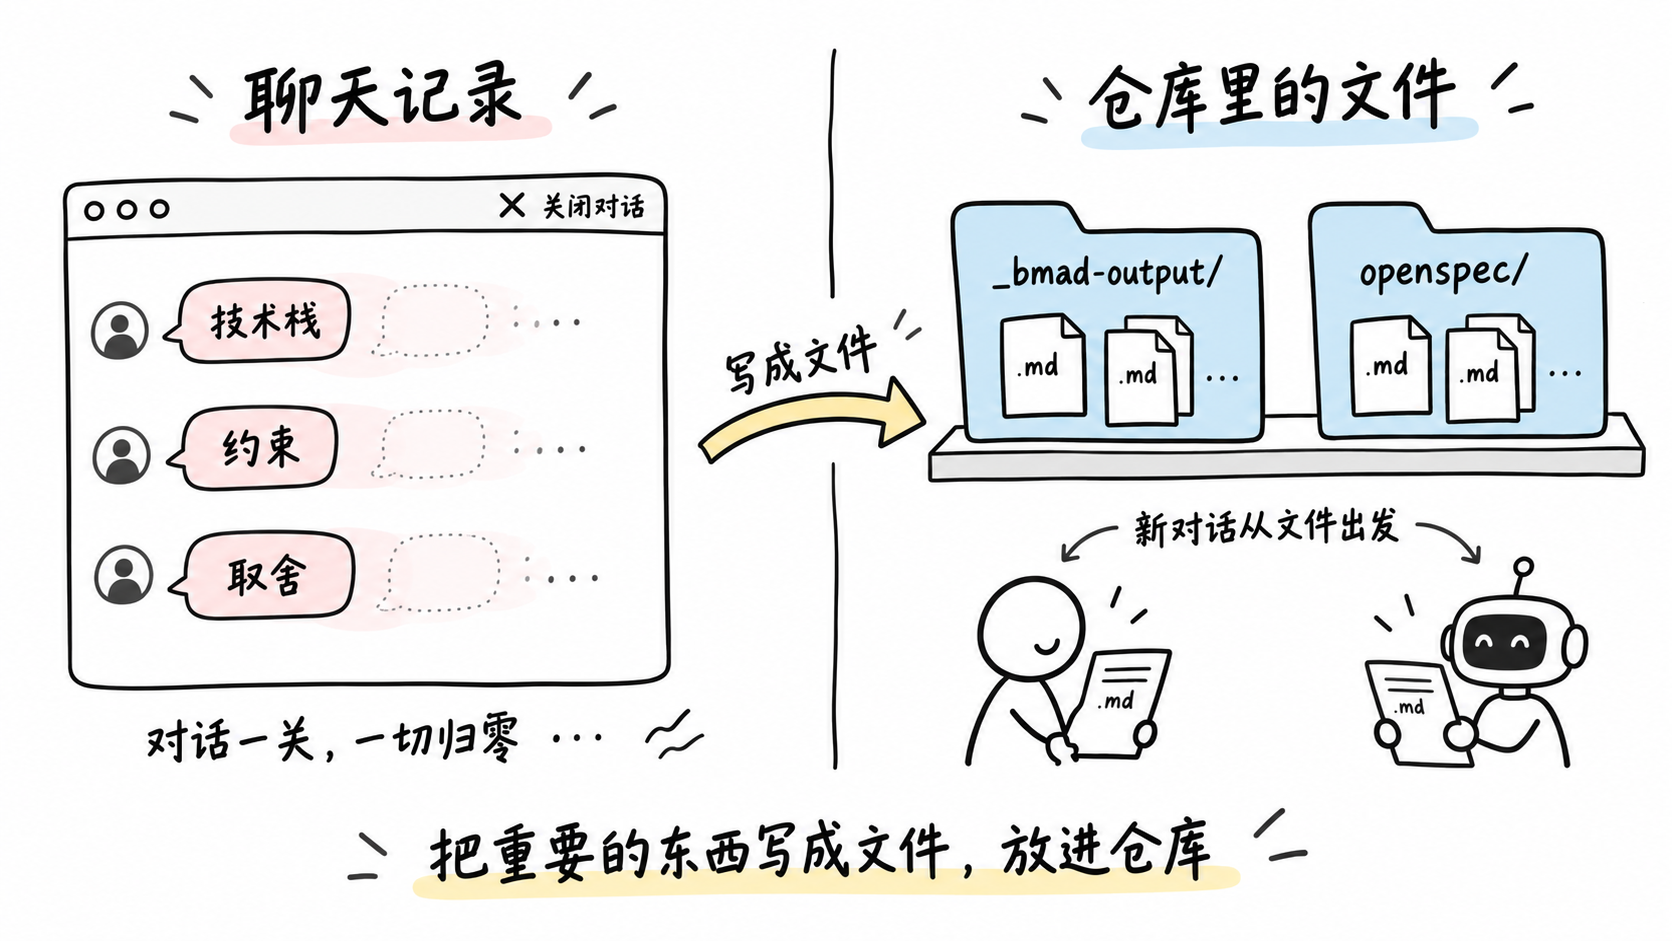
分歧在下一步。写什么文件,写多少,谁来写,写完怎么用。
BMAD,把一支团队的思考搬进流程
BMAD 的全称是 Breakthrough Method for Agile AI Driven Development。它的思路是借敏捷开发的那一套,让 AI 轮流扮演分析师、产品经理、架构师、UX 设计师和开发者,从一个模糊的想法一路走到能跑的代码。
我当时拿它从零做了一个前端小工具,叫 ec-calc,一个讲纠删码原理的可交互计算器。完整流程走下来是这样的。
- 从一份 16 行的产品想法出发,分析师 Agent 陪我做头脑风暴和调研。
- 产品经理 Agent 写 PRD,架构师 Agent 定技术栈、分层和关键决策,每份文档我都审一遍。
- 产品经理 Agent 把 PRD 拆成 Epic 和 Story,Scrum Master Agent 做 Sprint 规划,逐个生成 Story 文件。
- 开发 Agent 按 Story 一个个写测试、写代码、跑测试,再做代码审查。
头脑风暴是最让我惊喜的一段。 它一问一答地引导,每出 10 个想法就强制换一个维度,从技术换到商业,再换到边缘情况,为的是冲过前 20 个平庸想法。在这一步舍得用推理强的大模型,回报很高,LLM 的领域知识实在太广了。
代价也很具体。ec-calc 的核心逻辑不超过 500 行,BMAD 给它生成了 6 个 Epic、23 个 Story 文件,外加 PRD、架构文档、UX 设计、实现就绪报告。仪式性产出物的总量,远远超过了实际代码量。 每个对话都要重新读取状态和规则,token 用量跟着往上蹿。
当时我还吐槽过几处。Scrum Master、Retrospective 这些角色,原样搬给 LLM 有点生硬,LLM 不需要被「协调」,也不会疲劳。所谓的多 Agent,其实是我在不同对话里手动加载不同的 Prompt 文件。还有自审的问题,同一个模型既写代码又审代码,可信度要打折扣。
有意思的是,这几处后来 BMAD 自己动刀了。
- 角色合并了。 v6.3 把快速开发的 Barry、QA 的 Quinn 和 Scrum Master Bob 并进了开发 Agent Amelia。v6.1 起,工作流、Agent 和任务都改成了统一的 Skill,核心工作流从 YAML、XML 换成了 Markdown。
- 实现阶段收成了一条线。 v6.11 把 Quick Dev 改名为
bmad-build,定为官方唯一的写代码方式,第四阶段收成bmad-sprint-planning → bmad-build → bmad-code-review。原来的create-story、dev-story那一对被标记为弃用,Core 模块的技能从十四个砍到八个。 - 流程开始量体裁衣。 v6.12 的说法很直白,Build 先调查一遍改动,再决定要走多重的流程。简单的改动只配一份两节的 spec,一个会话就能做完。
- 审查开始讲证据。 几种审查方式合进了一个
bmad-review,用对抗式、边界情况、验证缺口等不同视角去看。v6.12 起,每一条审查发现都要记下结论和证据,不能悄悄丢掉。回顾也要求每一条发现都标出处。 - 真的能自己跑了。 新的 BMad Loop 模块,可以无人值守地把一整个 Epic 构建、验证、回顾完。
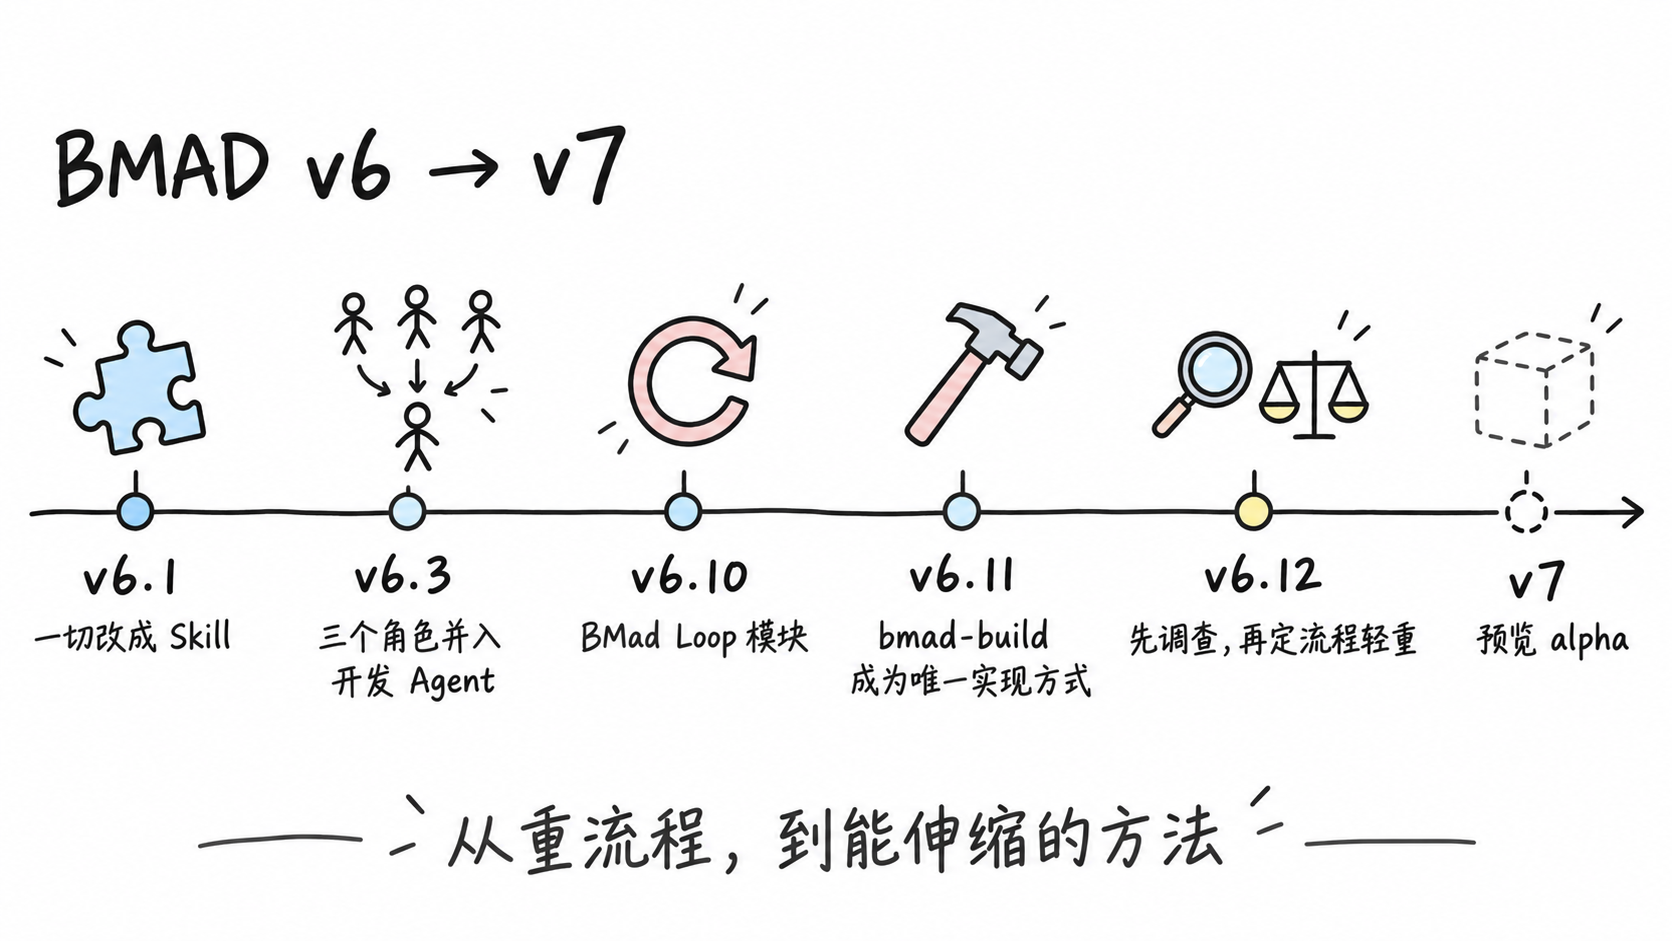
现在的稳定版是 v6.12,v7 正在预览 alpha,可以通过 Skills CLI 或 Claude Code、Codex 的插件市场安装。稳定版的安装方式没变。
npx bmad-method install注意它现在需要 uv 来跑 BMad 的配置和 Python 脚本,装之前先把这个准备好。
所以我对它的印象得更新一下。BMAD 不再是「只适合大项目的重流程」,它正在变成一套能伸缩的方法。小改动直接 build,大项目再一层层往上加规划。但它的底子没变,它关心的是从想法到交付的整个过程,产品、架构、UX、测试这些视角,它都想替你请到桌边来。
BMAD 的 README 里有一张交付循环图,把这层意思画得很直白。想法还模糊,从澄清开始。想法清晰又大,进规划。改动很小,直接构建和验证。做完以后学到的东西,再绕回去调整计划。
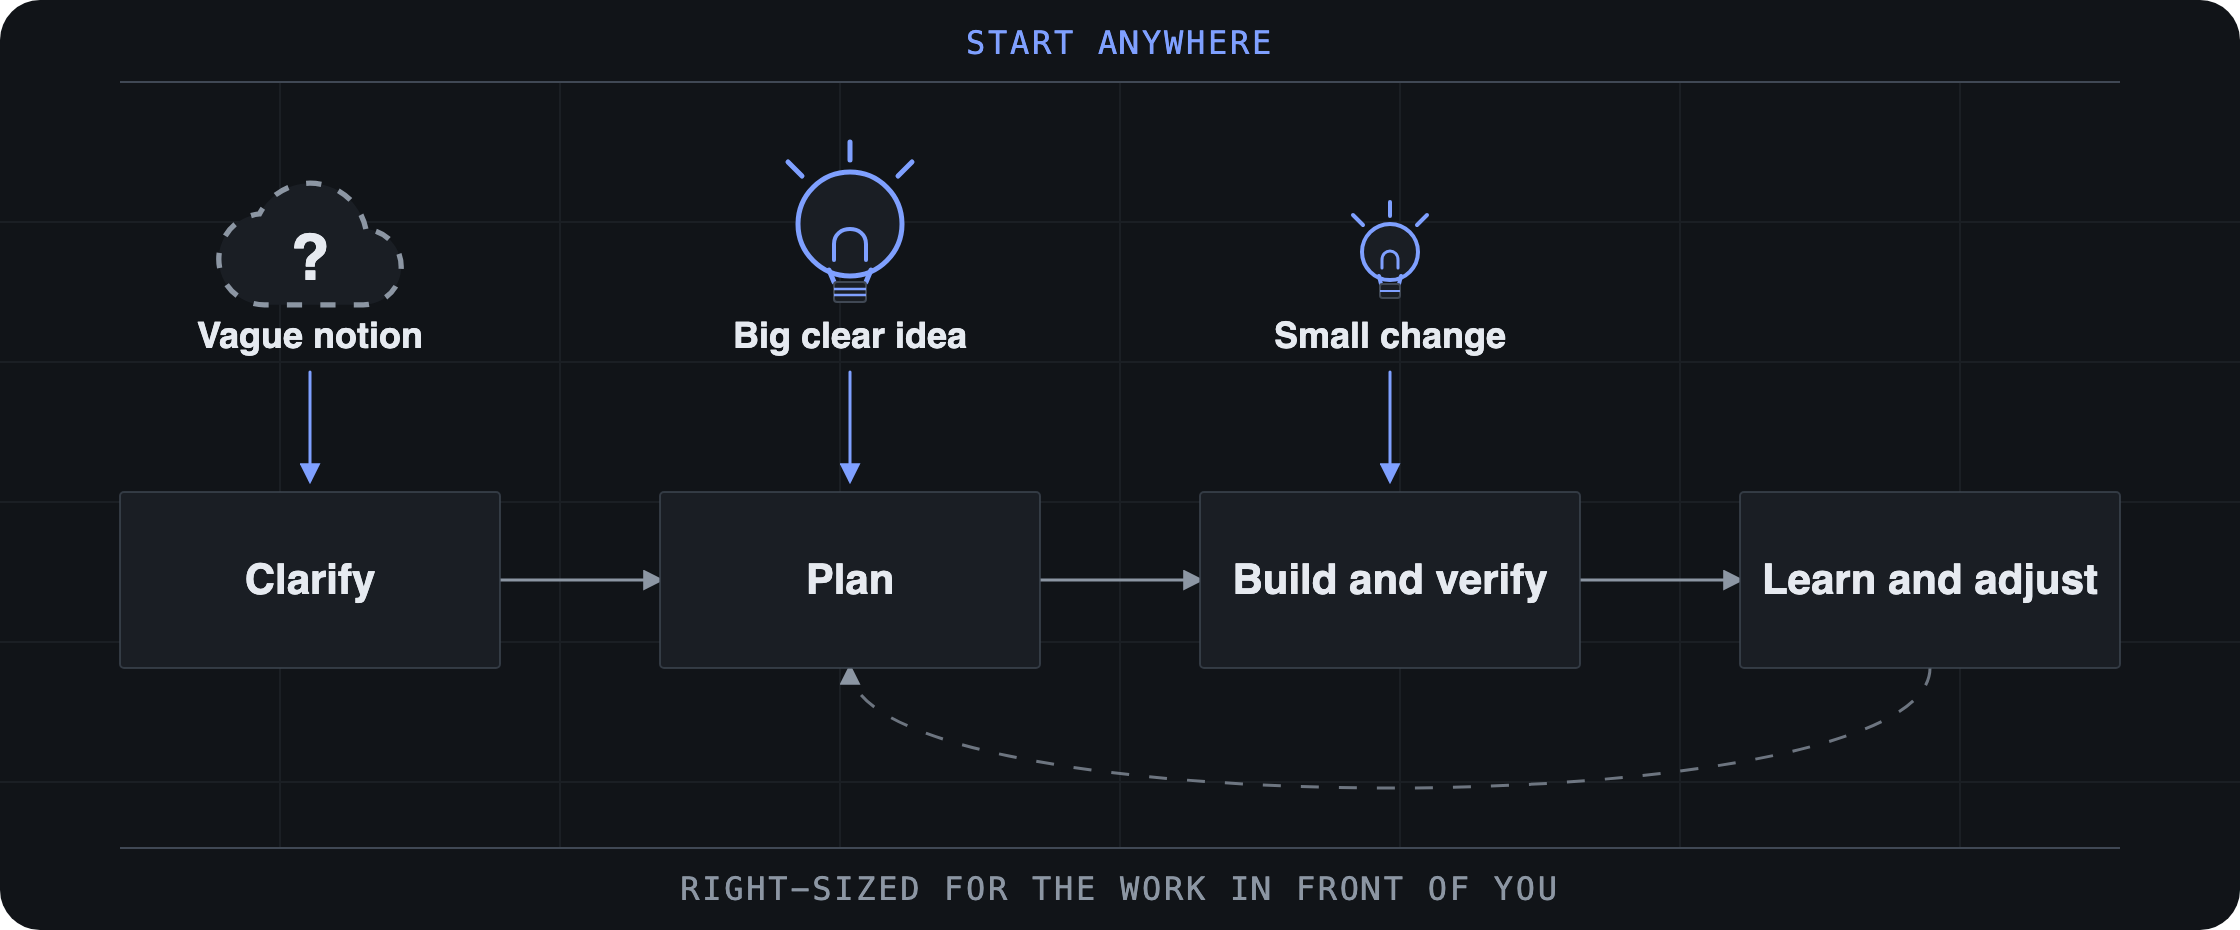
图出自 BMAD 官方仓库,MIT 许可。
OpenSpec,只管把这一次改动讲清楚
OpenSpec 的野心小得多,小得很克制。它不打算模拟一支团队,只想在你和 AI 之间加一层轻量的规格。官方给自己写的原则只有几条,灵活而非死板,迭代而非瀑布,简单而非复杂,为存量项目而生,从个人项目到企业都能用。
整个体系建立在一个二分法上。
openspec/
├── specs/      ← 系统现在是什么样的
└── changes/    ← 我们打算改什么
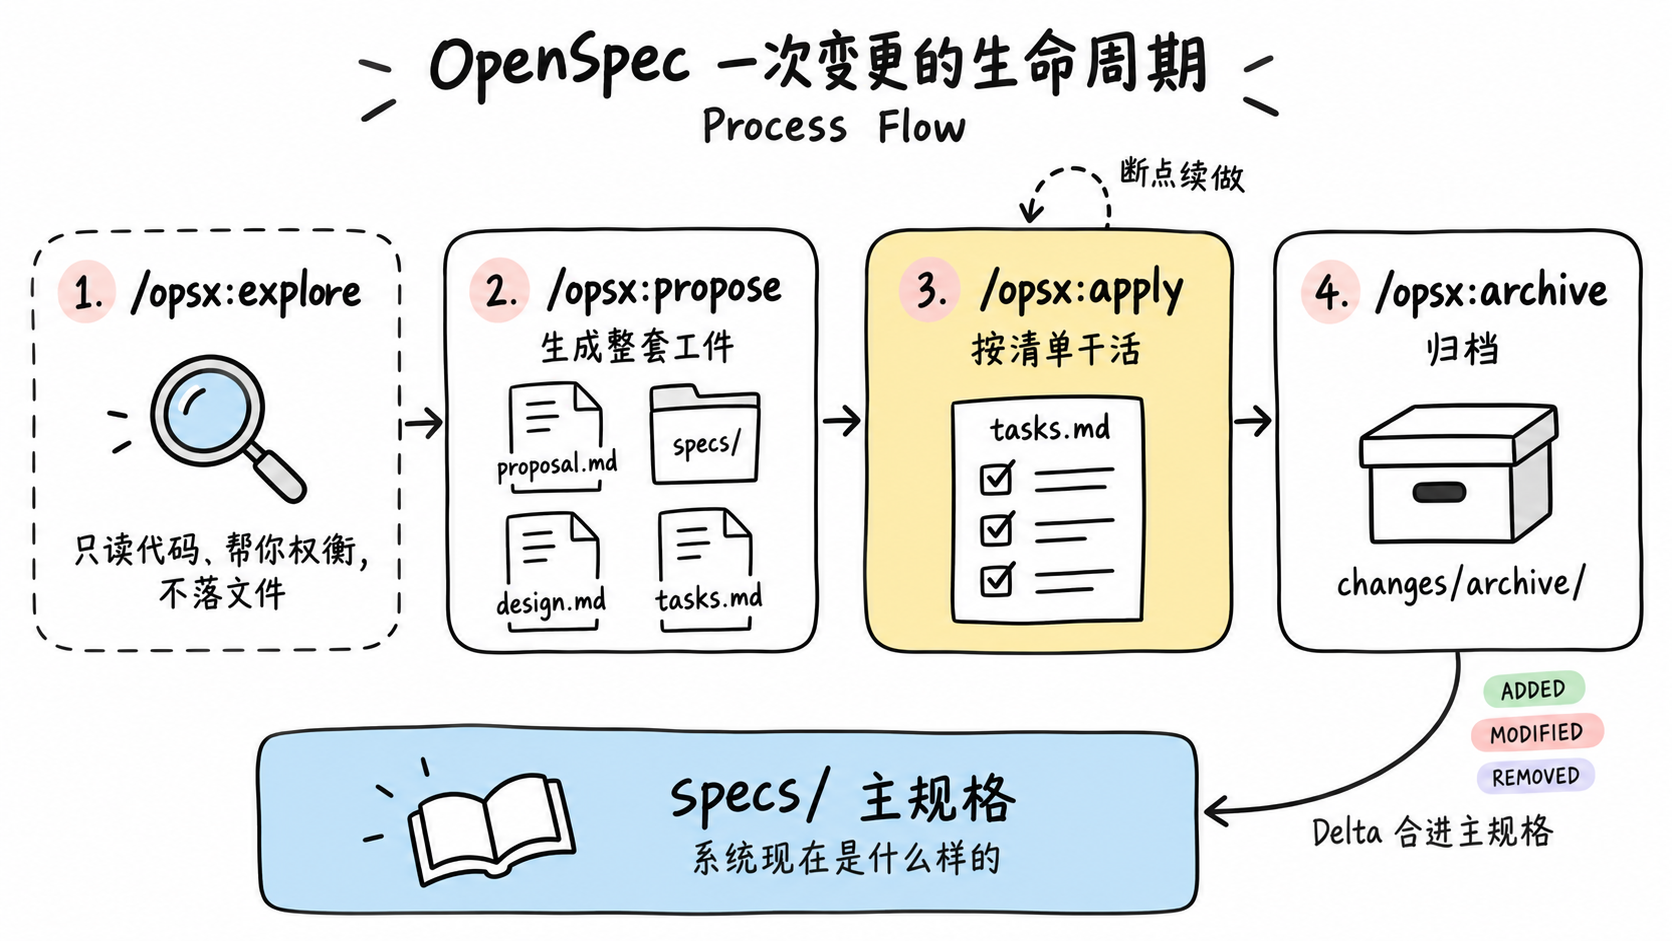
specs/ 是系统当前行为的权威描述。changes/ 里,每个功能、每个 Bug 修复独立一个文件夹,各放一份 proposal.md、specs/、design.md 和 tasks.md,分别回答为什么做、行为怎么变、技术上怎么做、具体干哪几件事。
最妙的是 Delta Specs。改一个功能,不用把整个系统的规格重写一遍,只写这次的 ADDED、MODIFIED、REMOVED。归档时,这些增量自动合进主规格,变更目录移进 openspec/changes/archive/ 下带日期的文件夹。规格写出来大概是这样,纯 Markdown,没有要额外学的语法。
## ADDED Requirements

### Requirement: Theme selection
The app SHALL let users switch between light and dark themes,
defaulting to the system preference.

#### Scenario: User toggles dark mode
- **WHEN** the user clicks the theme toggle
- **THEN** the app switches to dark mode and persists the choice
日常用起来,就是几个斜杠命令。想不清楚先 /opsx:explore,它只读代码、帮你权衡,不落文件。想清楚了 /opsx:propose 一口气生成整套工件,扫一遍没问题就 /opsx:apply 按清单干活,做完 /opsx:archive。中途被打断,下次开个新对话再 /opsx:apply,它读 tasks.md,看哪些打了勾,从断点接着来。
这种体验很像在工地上贴施工单。它不问你这个产品该不该做,只问你这次到底要改什么。
OpenSpec 这段时间更新得很勤,大多数改动都在往同一个方向使劲,让规格更不容易悄悄出错。
/opsx:sync进了默认安装,新增了/opsx:update,可以只修订规划工件,不碰实现。openspec show <change> --diff只把真正变化的行拎出来,审查 MODIFIED 的时候不用在大段相同文字里找不同。openspec status最后会多一行Next:,直接告诉你下一步该敲哪条命令,断点续做不再需要背流程。- 纯重构、纯文档的改动可以声明
skip_specs: true,不用硬编一份规格。 - propose 和 ff 在起草工件前会先看相关代码、测试和文档。apply 遇到一份规格都没有的变更也会提醒,归档和 delta 解析不再悄悄改动或丢掉你写的内容。
- 面向团队的 Stores 进入 beta,把规划放进一个单独的仓库,一个变更可以横跨好几个代码仓库。
在终端里敲 openspec view,能看到一块仪表盘,主规格有几份、需求有多少条、哪些变更还在做、任务完成了几成,一屏看完。v1.14 起,它还会单独列出已归档的变更,标出每个活跃变更的工件哪些已完成、哪些还卡着。
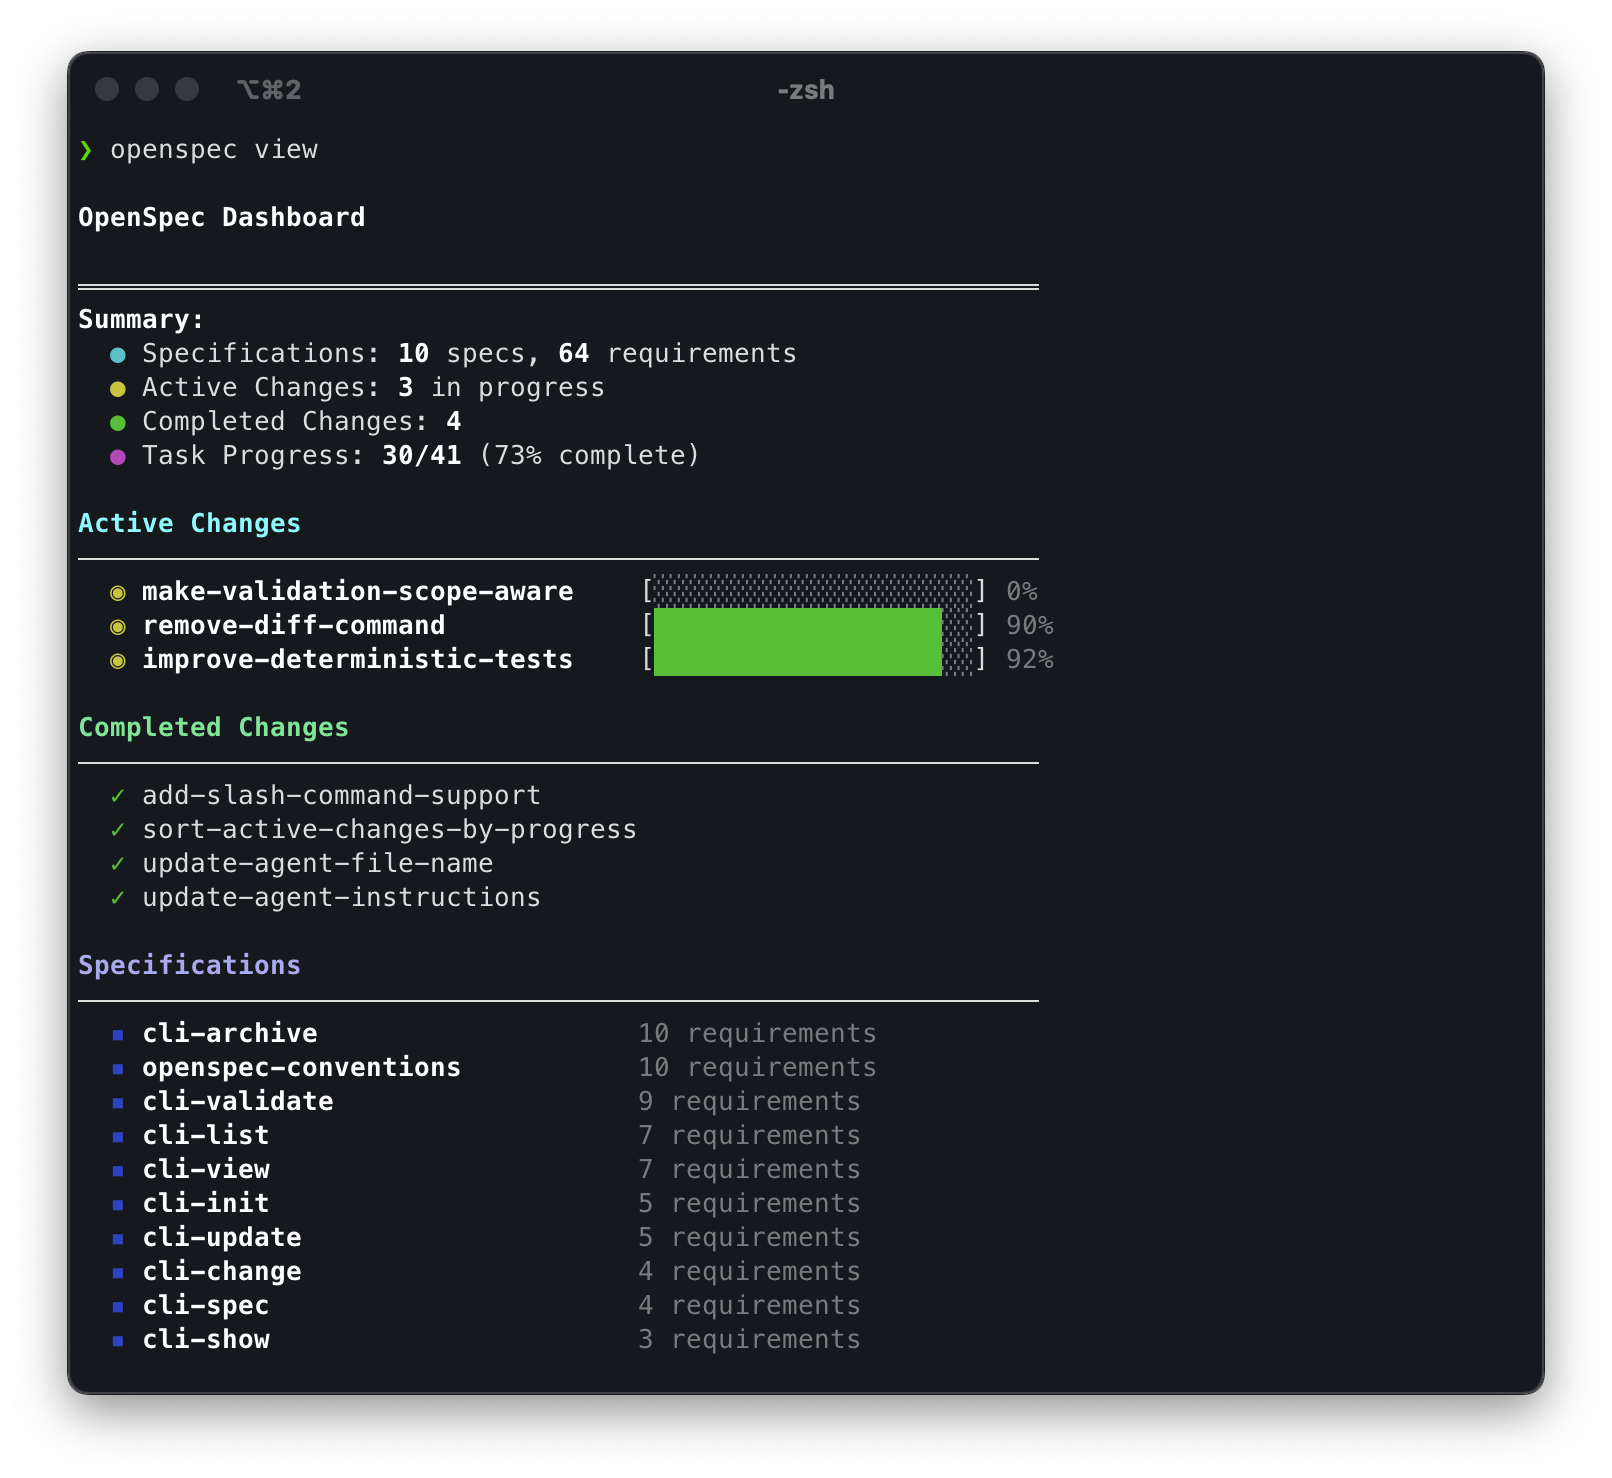
截图出自 OpenSpec 官方仓库,MIT 许可。
截至 v1.14,它已经支持三十多种 AI 编程工具。安装一如既往地简单,要求 Node.js 20.19.0 以上。
npm install -g @fission-ai/openspec@latest
cd your-project
openspec init
macOS 上也可以直接 brew install openspec。
桌边还坐着一个 Spec Kit
聊规格驱动,绕不开 GitHub 官方的 Spec Kit。OpenSpec 的 README 里专门拿它做过对比,说它周全但偏重,阶段门禁严格,Markdown 很多,还要装 Python 环境。这是 OpenSpec 自己的说法,听一半就好。
Spec Kit 现在到了 v1.2,需要 Python 3.11+ 和 uv。它的主线是每个项目先定一份 constitution,然后每个功能走 specify、plan、tasks、implement、converge。修 Bug 和评估一个想法值不值得做,则作为可选扩展单独安装。
放在这里一比,它的位置大概在 BMAD 和 OpenSpec 中间。比 OpenSpec 更讲究阶段,又不像 BMAD 那样请来一整支团队。
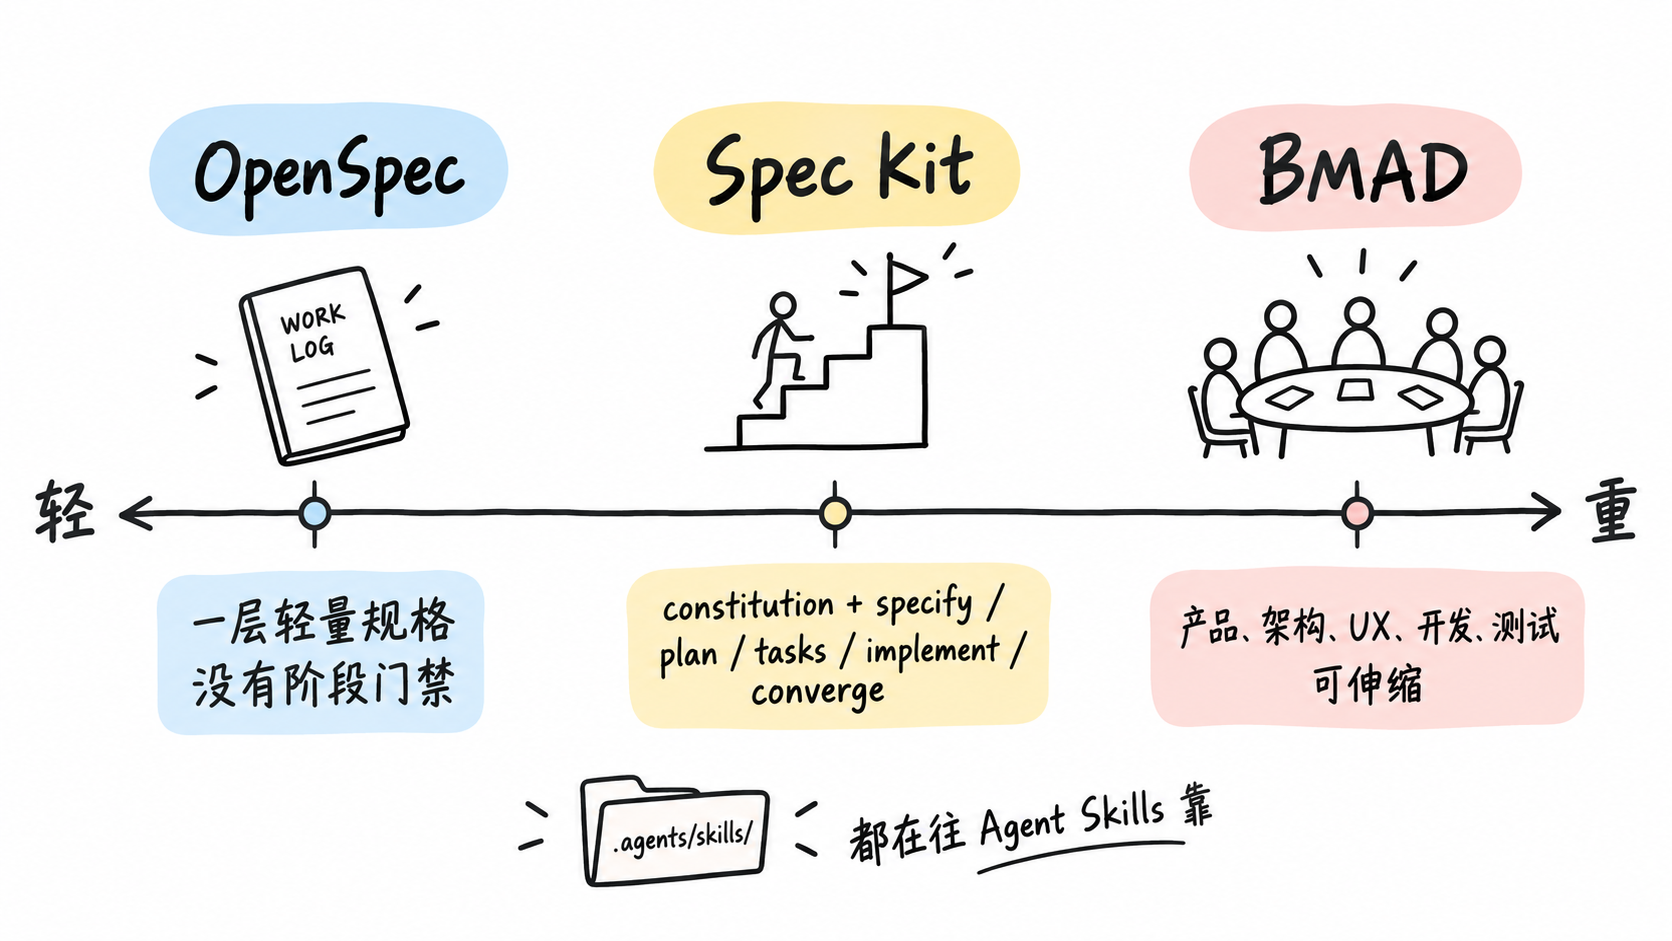
三家最近还有一个共同的动向,都在往 Agent Skills 靠。BMAD 从 v6.1 起把一切改成 Skill,v6.5 起在支持的平台上统一写进跨工具的 .agents/skills/ 目录。OpenSpec v1.8 加了一个中立的 agents 目标,同样写进 .agents/skills/。Spec Kit 的流程也是在 Agent 对话里一个个调用的 /speckit-* Skill。
工具本身越来越像,流程变成了可以装、可以卸的技能包。剩下要选的,主要是你想给 AI 配多重的流程。
放在一张桌子上看
两个工具的差别,拆开来看大概是这样。
| 维度 | BMAD | OpenSpec |
|---|---|---|
| 关心什么 | 从想法到交付的整个过程 | 每一次变更讲没讲清楚 |
| 核心产物 | 简报、PRD、架构、UX、Epic 与 Story | specs/ 主规格、changes/ 变更与 Delta Specs |
| 流程重量 | 可伸缩,小改动直接 build,大项目层层规划 | 轻,没有阶段门禁,工件随时可改 |
| 进度记在哪 | 状态文件和 spec frontmatter | tasks.md 的复选框 |
| 知识怎么沉淀 | 前期规划文档定方向 | 每次归档,主规格长一点 |
| 擅长的起点 | 想法还模糊、从零开始的新项目 | 已经有代码、需求零碎的存量项目 |
| 上手成本 | 角色和技能多,需要 Node.js 和 uv | 一个 npm 包,几个斜杠命令 |
| 多视角 | 产品、架构、UX、开发、测试分别出场 | 没有角色,专注规格本身 |
一句话收一下,BMAD 管的是想清楚,OpenSpec 管的是记下来。
当然这句话有点偷懒。BMAD 也在记,它的 Story 文件和状态文件一样能接住断点。OpenSpec 也在想,/opsx:explore 就是专门用来想的。只是两个工具把力气花在了不同的地方。
什么时候用哪一个
我自己的判断,按场景分。
一句话就能说清的小改动。 修个样式、改个文案、加一个字段,两个都可以不用,直接改、直接测。真要留痕,OpenSpec 的 propose 或 BMAD 的 build 都够轻。
从零开始,想法还很模糊。 这是 BMAD 的主场。头脑风暴、调研、PRD、架构,一层层把模糊的东西逼成具体的东西。项目越大,越需要产品、架构、UX 这些视角在动手前就把冲突摊开,BMAD 的那些规划文档就越值回 token。
BMAD 官方文档按规模给了四条路径。琐碎的改动,改完验证就行。一个会话能做完的,从意图直接进 Build。Epic 大小的,先写 spec、拆 Story,每个 Story 跑一次 Build,最后整合和回顾。项目级的,先立产品、UX、技术的共享约定,再把 Epic 那条路重复几遍。
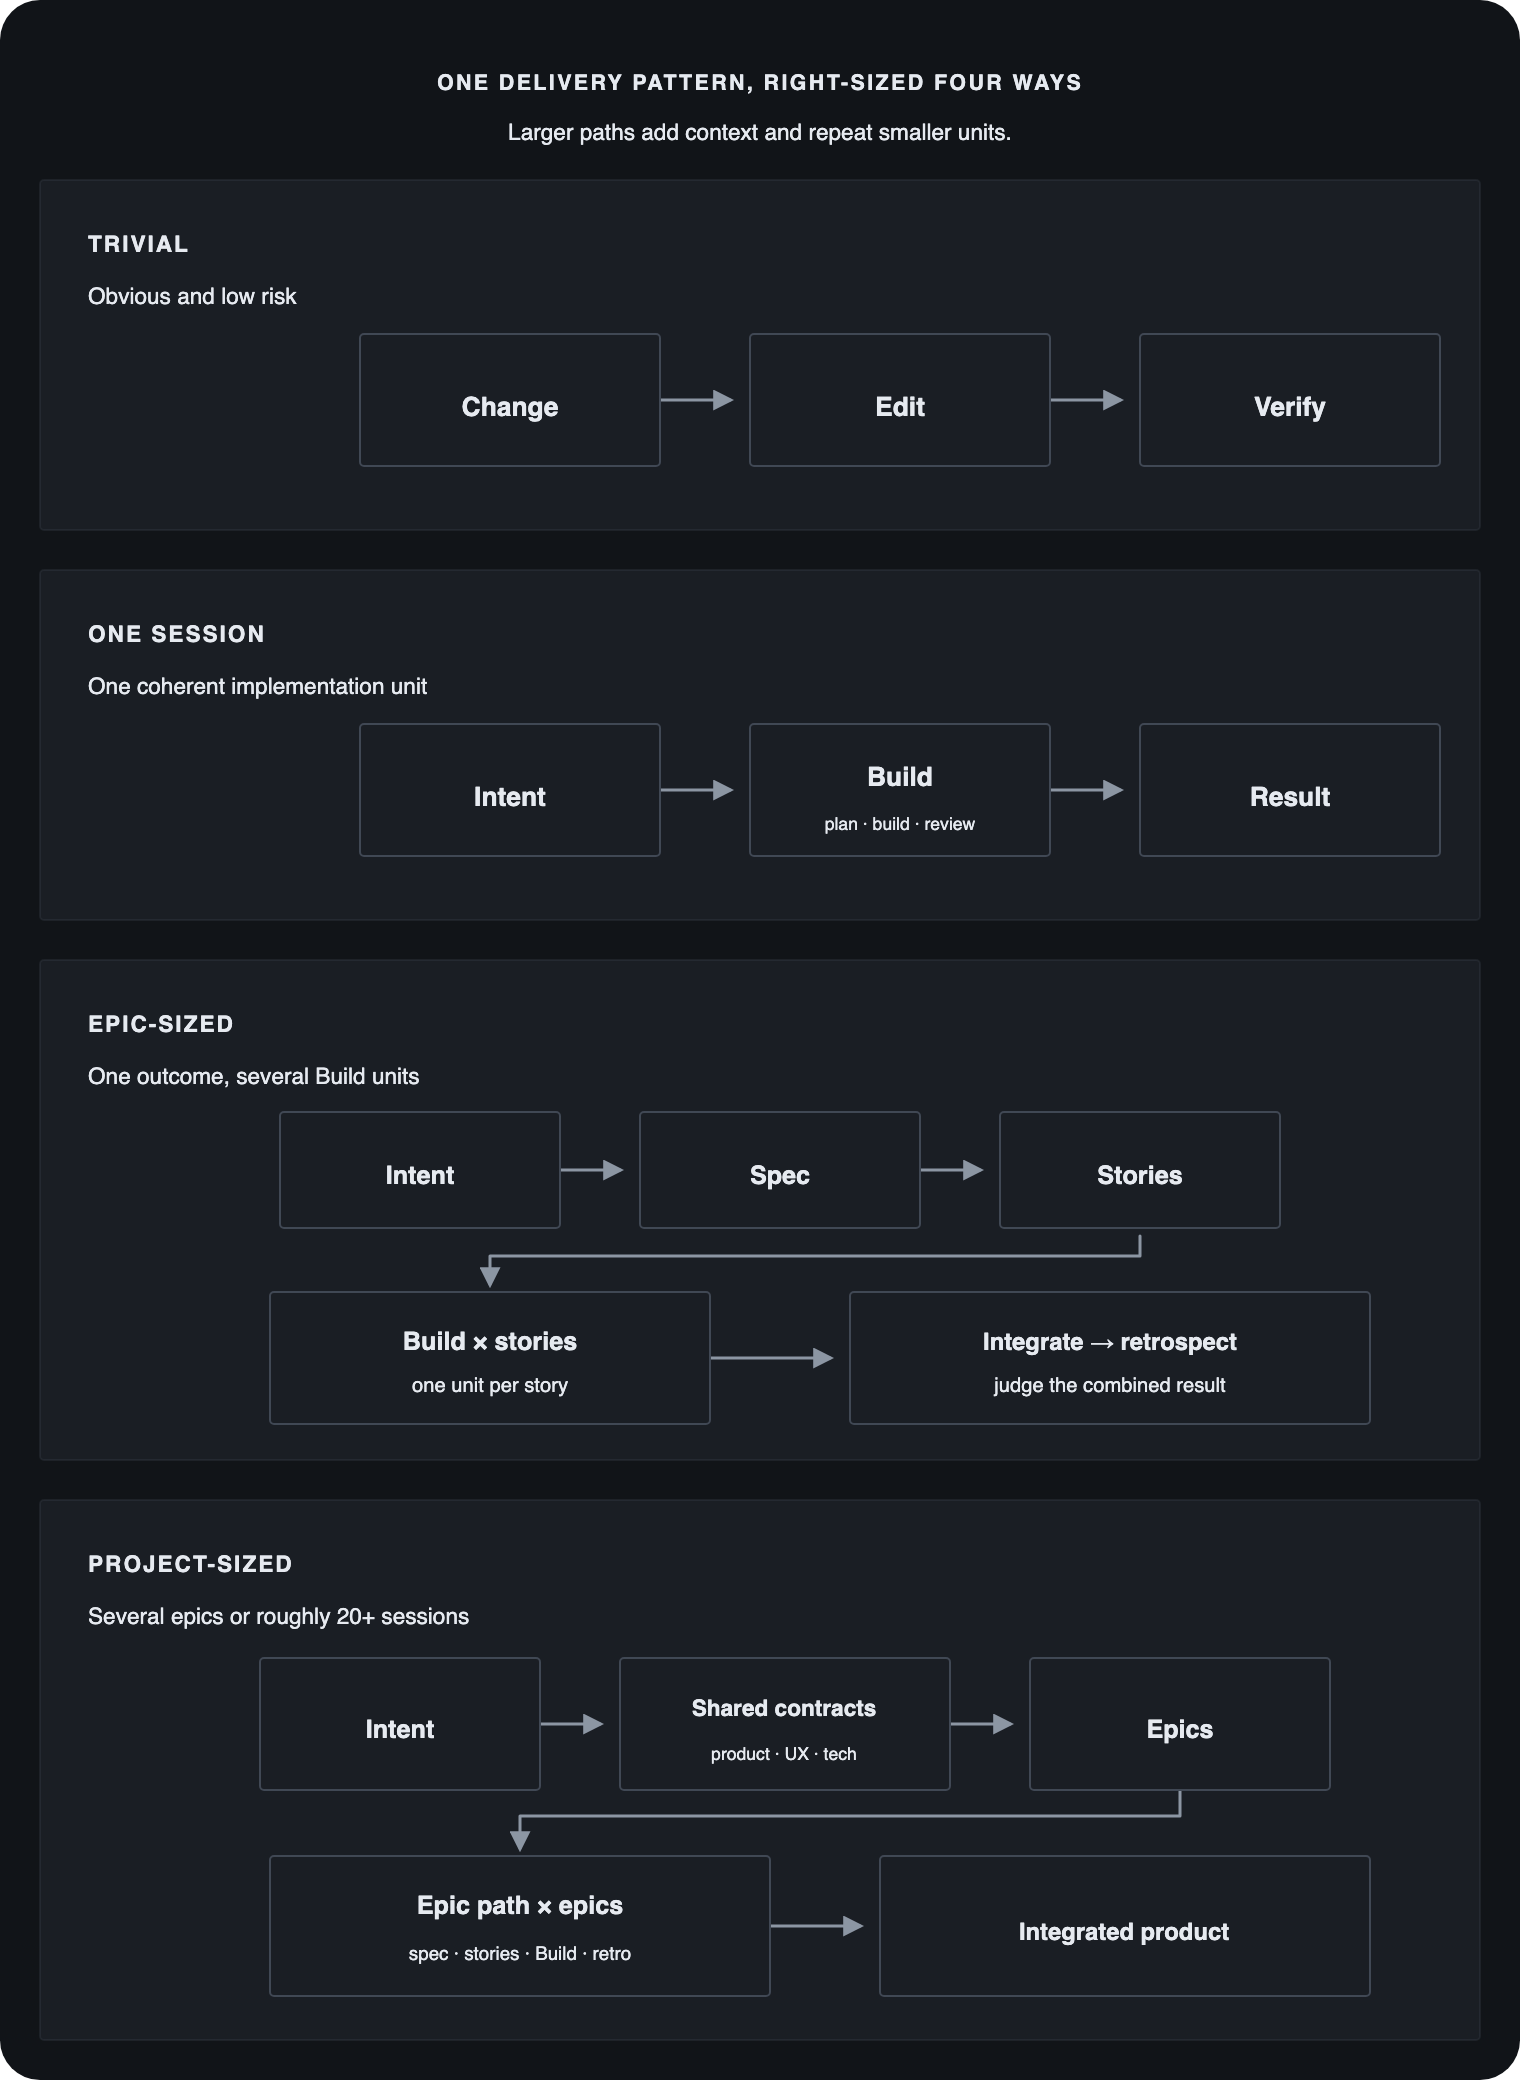
图出自 BMAD 官方文档仓库,MIT 许可。
已经有一摊代码,要长期迭代。 这是 OpenSpec 的主场。你不需要先给整个系统补一份完整规格,从第一个变更开始用就行。几次归档之后,openspec/specs/ 会自然长成一份可用的系统行为手册,这一切都是在正常开发里顺手攒出来的。
手上同时推进好几个功能。 OpenSpec 的变更天然隔离,各自一个文件夹,切换时只要换个变更名,最后统一归档。BMAD 按 Epic 和 Story 组织,适合有先后依赖的一整串工作。
想让 AI 一口气跑完一整段。 BMAD 的 BMad Loop 是冲着无人值守去的。OpenSpec 不打算替你编排整段流程,它更愿意你在每个工件节点上看一眼。
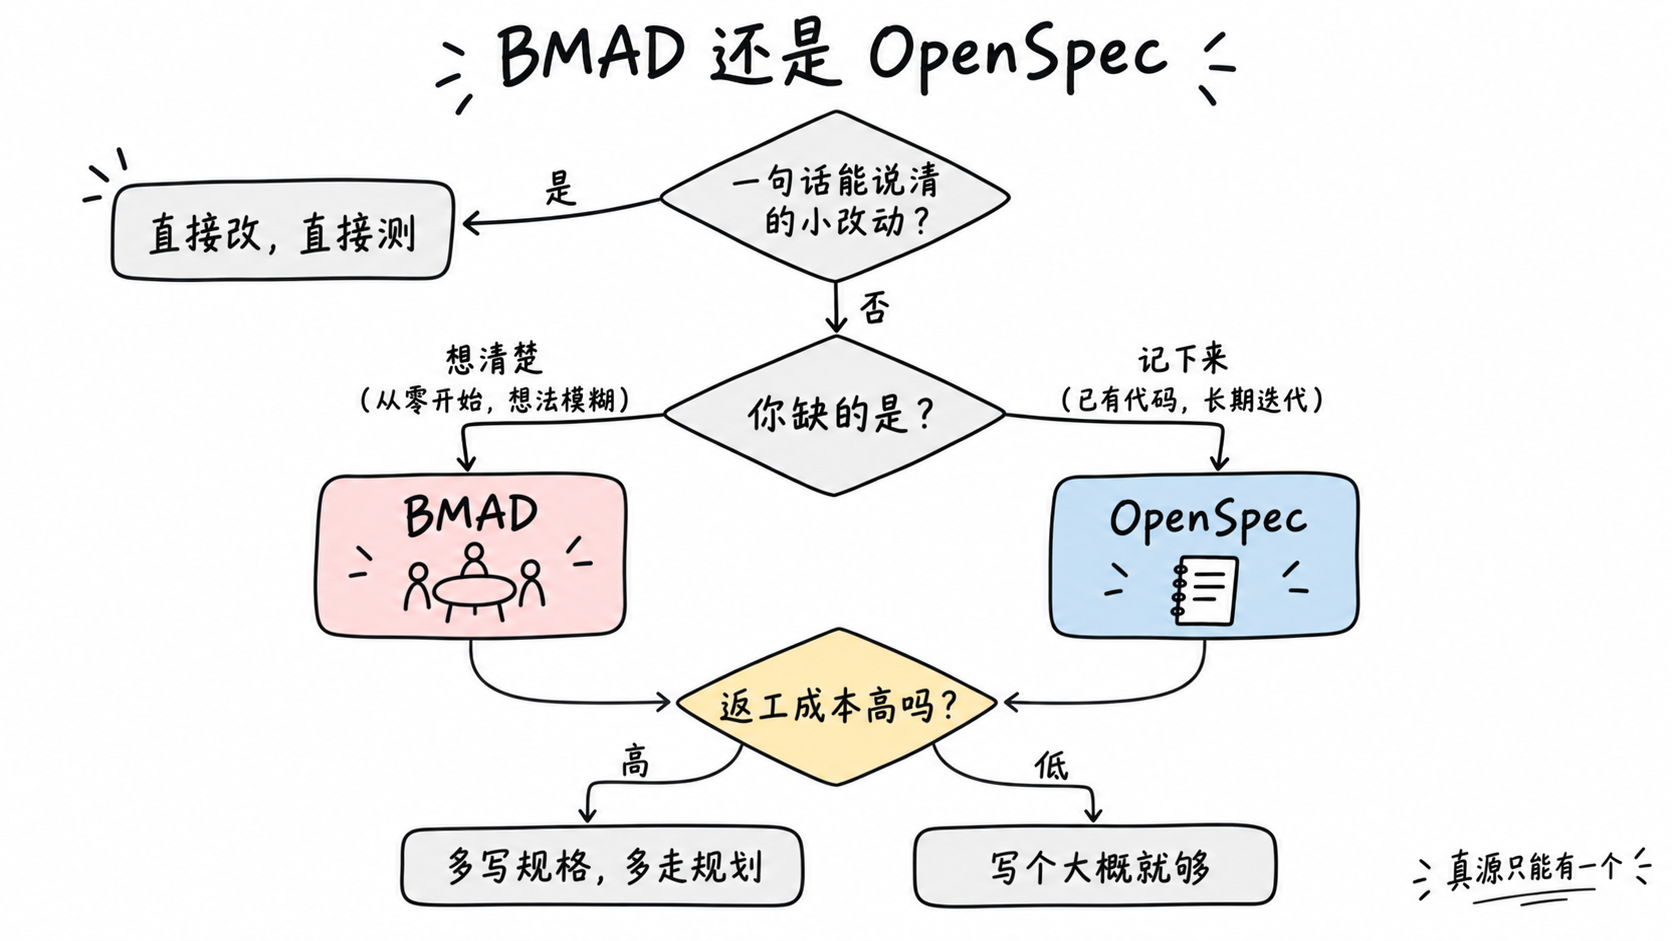
两个能不能一起用? 我的看法是可以分段用,但别叠在一起用。比如新项目前期用 BMAD 把产品和架构想清楚,主体落地以后,零碎的改动交给一套更轻的规格流程。最怕的是同一件事在 _bmad-output/ 和 openspec/ 里各写一份,两边一对不上,AI 也不知道该信谁。真源只能有一个。
还有一个判断标准,是从 OpenSpec 的文档里学来的,我觉得对两个工具都适用。这个改动搞砸了,返工成本高不高。 高,就多花点时间写规格、走规划。改错了五分钟就能修好,写个大概就够了。
两个都替你做不了的事
最后说点泼冷水的。
不管是 BMAD 的审查视角,还是 OpenSpec 的 /opsx:verify,都是 AI 拿着文件去检查 AI 写的代码。两家都在补这块短板,BMAD 要求每条审查发现都带证据,OpenSpec 的 verify 改成如实报告自己查了什么。这些都让检查更可信,但做不到让它独立。
我做 ec-calc 的时候体会很深。前端项目,必须人在环里,亲手点一遍,体验有问题再反馈回去修。测试是 AI 写的,代码也是 AI 写的,它们可能犯同一个错。
所以这两套东西,与其说是让 AI 更聪明,不如说是让「对不对」有处可查。规划文档也好,Delta Specs 也好,都是给人回头对照用的。对照这件事,还是得有人真去做。
另外,两个工具对模型的推理能力都很敏感。规划、拆解、写规格这几步,尽量用推理强的模型。真正照着清单写代码的阶段,要求可以低一点。开始实现之前,最好开一个干净的新对话,让 AI 从文件出发,别被前面讨论阶段的噪音带偏。
回到那两个文件夹
现在再看项目根目录里那两个文件夹,我的理解是这样的。
_bmad-output/ 像一间会议室,适合在动手之前,把该吵的架吵完。openspec/ 像一本施工日志,适合在动手的过程中,把每一刀切在哪记清楚。
你缺的是想清楚,就先进会议室。你缺的是记下来,就翻开那本日志。脑洞先落地,细节慢慢打磨,两个文件夹都是为后半句准备的。
参考资料
鸿尘客 Honchic · 把脑洞焊到电路板上