在 Windows 上,用 Screenpipe 留下屏幕上的工作线索,用本地 Ollama 整理成可查找的活动日志,再写入 Notion。日志按时间攒在数据库里,日报、周报、月报是之后拿这些记录做的汇总。本文把插件部署、数据库授权、模型设置和开机启动串起来,说明采集、归档和汇总各自怎样工作。
2026 年 10 月补记。 正文写于 2026 年 1 月。那时候,OpenClaw 这类个人智能体还没有爆发。现在 Codex、Hermes 等智能体已经能接上 Notion MCP,再配定时任务,可以用更简单的方式完成和本文相同的事。
这条链路还有一个越来越划算的地方。活动日志由本机离线的 Ollama 整理,这一步不按云端 token 计费。token 费用日渐增高,本地模型能把整理成本大幅降下来。下面仍保留当时的完整做法,方便对照每一步原来是怎么接上的。
代码开源
日报最费劲的地方,往往不是写那几句话。
是把一天重新想一遍。
编辑器里改过的文件,浏览器里翻过的资料,会议里说过的话,散在不同窗口里。下班前再挨个找回来,记忆已经开始挑着重要的留下了。
我想把这段重复劳动交给机器。屏幕上的线索先留下,整理成能按时间查找的工作日志。写日报、周报、月报时,直接翻这些记录。
这套工作日志用到三个工具,Screenpipe 负责记录,Ollama 负责分析,Notion 负责归档。下面把 Windows 上的插件部署、模型设置、Notion 连接和开机启动串起来,连同几个容易漏记录的地方一起说明白。
让流水线替我上班,先得把每一步交接说清楚。
屏幕记录怎样落成工作日志
Screenpipe 在本机采集屏幕文字、音频转写等活动数据。Notion 插件定时查询这些数据,把应用、窗口和文字内容交给模型,生成标题、描述和标签,再写入 Notion 的活动日志数据库。
到这一步,保存下来的是一条条工作记录。
日报和周报还有下一步。用 Notion AI 读取活动日志,按日期整理成日报,再把日报汇总成周报。原来的使用方式需要在 Notion 中输入指令触发;插件里的定时任务没有代替这个动作。
| 环节 | 工具 | 处理什么 | 结果放在哪里 |
|---|---|---|---|
| 留下工作线索 | Screenpipe | 屏幕文字、音频转写及时间信息 | 本机数据库与媒体文件 |
| 整理活动记录 | Notion 插件 + Ollama | 查询到的数据,结合提示词生成日志 | 经 Notion API 写入 Activity Logs |
| 汇总日报、周报 | Notion AI | 指定日期的活动日志或已保存的日报 | 工作日志中心的日报、周报数据库 |
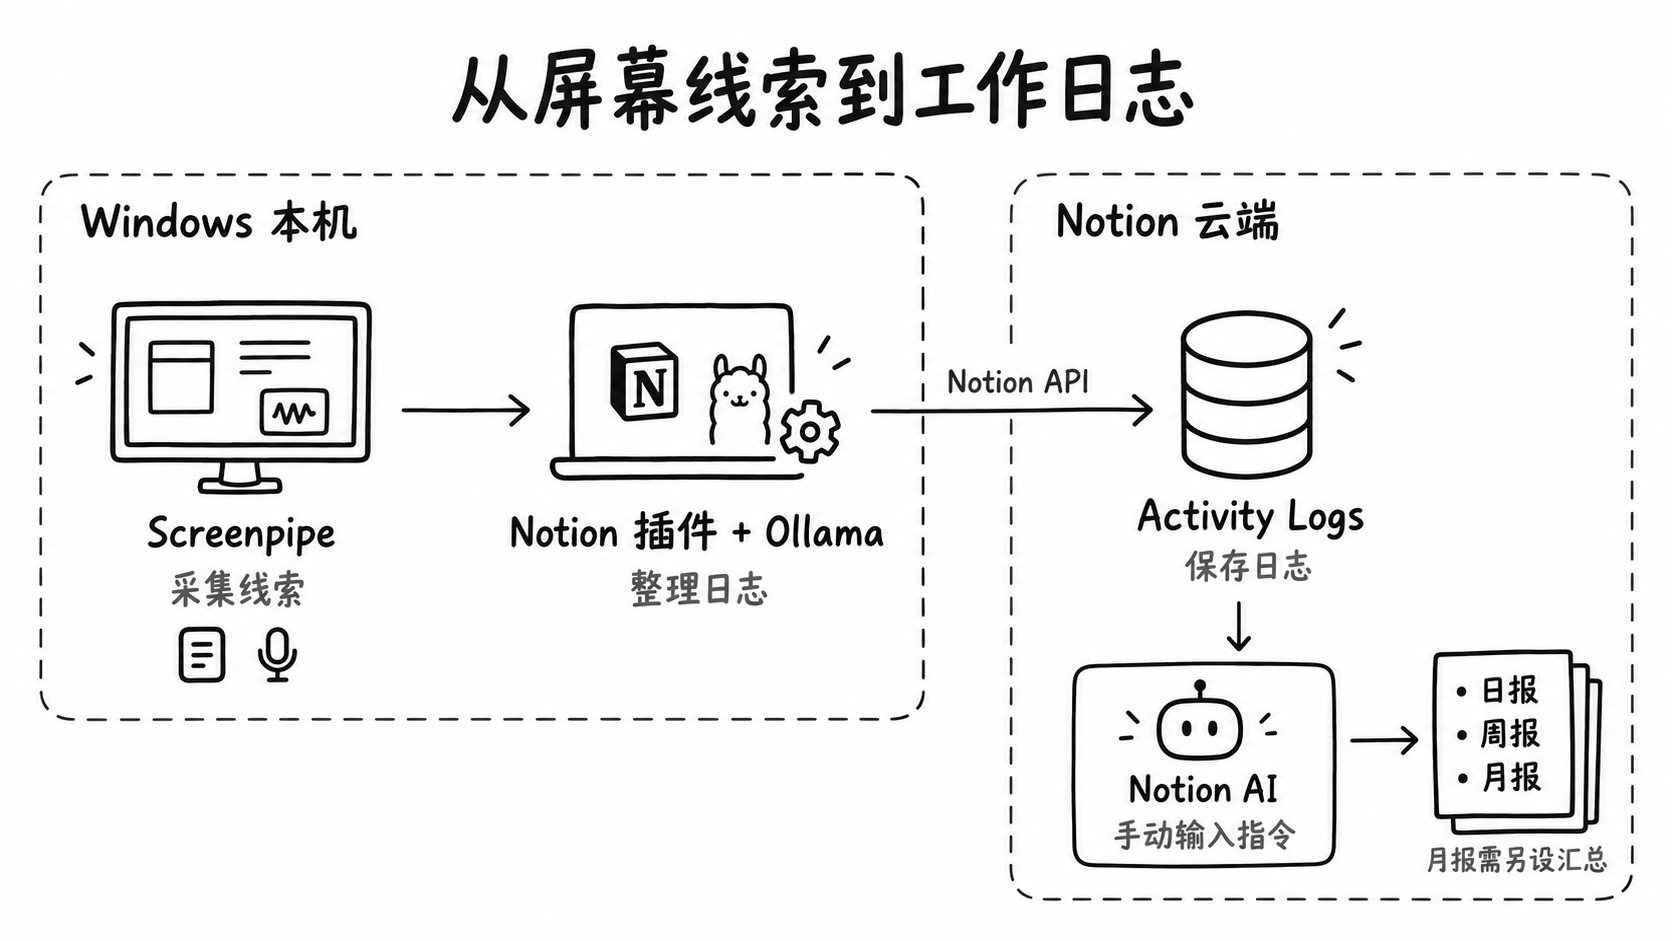
这个分工也划清了数据去向。使用本地 Ollama 模型时,模型分析在本机进行;写入 Notion 的日志会进入云端。在 Notion AI 中汇总,又多了一段云端处理。选择这套方案时,需要接受这两处数据流向。
另外,屏幕上出现过一段代码,能说明你看过或编辑过它,不能直接证明它已经编译、部署或修好了某个问题。日报里的成果和耗时,仍然要能对上真实记录。
先把 Screenpipe 和 Ollama 启动起来
Screenpipe:准备兼容的插件环境
这份项目是带 pipe.json 的 Next.js 插件,使用旧版 Screenpipe Pipes 机制。新版 Screenpipe 的 Scheduled tasks 使用 pipe.md,两种目录里的文件虽然都叫任务,运行方式不同。新版任务界面不能直接当成下面这份插件的启动器。
复刻这份项目前,先确认安装的 Screenpipe 版本仍支持 Next.js Pipes,并检查命令帮助里是否有下面用到的插件管理方式。官方安装入口和任务文档见本文网站页面的参考资料。
启动兼容版本的 Screenpipe 后,让它产生一些屏幕活动数据。插件放在当前用户的 .screenpipe/pipes 下,Windows 示例路径为 C:\Users\你的用户名\.screenpipe\pipes\notion。如果你另设了 Screenpipe 数据目录,后面的插件位置和清理脚本也要跟着改。
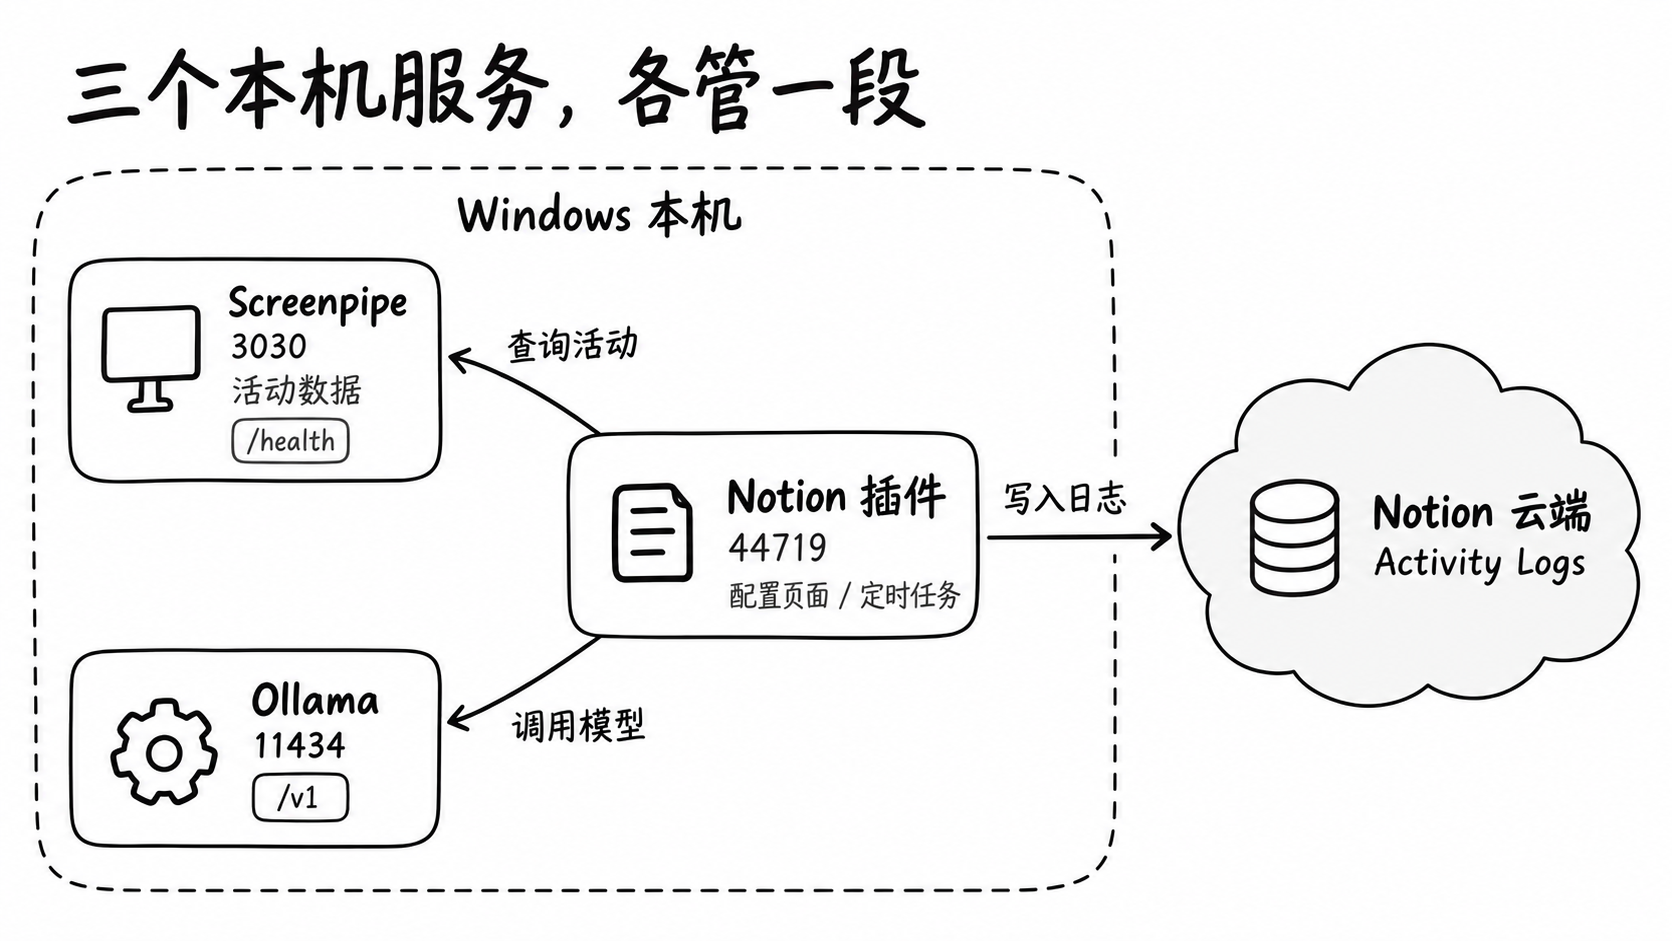
本机 Screenpipe 服务与 Notion 插件是两个服务。查询数据用到的 Screenpipe 默认端口是 3030,这份插件的页面端口是 44719。打开插件页面,并不代表底层采集服务也已经正常工作。
可以用 PowerShell 查看本机服务状态。
Invoke-RestMethod -Uri 'http://localhost:3030/health'检查 Screenpipe 的采集状态,并确认查询能拿到近期记录,再往下配置模型。刚启动就没有记录时,先让它采集一会儿。
Ollama:模型要能用,也要接对接口
安装 Windows 版 Ollama 后,在终端下载这份项目使用的 Qwen2.5 模型。
ollama pull qwen2.5
ollama list
ollama run qwen2.5
ollama list 用来检查已下载的模型;ollama run 可以先做一次简单对话。模型规模和运行速度会受内存、显存与设备影响,不必为了复刻教程把上下文滑块拉满。
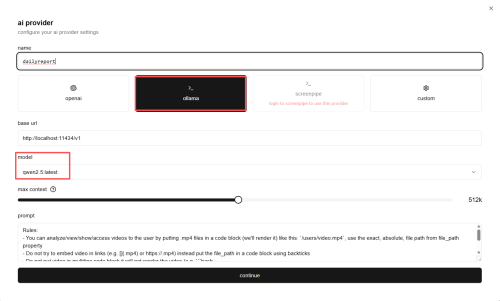
插件通过 OpenAI 兼容接口访问 Ollama。配置示例是本机 11434 端口下的 /v1,不是只填端口,也不是换成 Ollama 原生的 /api/chat 路径。
{
  "url": "http://localhost:11434/v1",
  "model": "qwen2.5:latest"
}这里的模型名称要与本机列表一致。/v1 是兼容接口的基础地址,插件会在它后面调用模型列表和聊天接口。选择「Ollama」预设,同时确认实际地址指向本机,才能让这一步使用本地推理。
把 Notion 插件放进工作流
从本文网站页面取得项目代码,解压后将插件文件夹命名为 notion,放到兼容版 Screenpipe 的 pipes 目录。
目录里应能看到 package.json、pipe.json 和 src。这份插件使用 Next.js 15.1.0、React 19,以及 @screenpipe/js、Notion SDK 等依赖;按项目自身的依赖配置构建,不要把它换成另一套新任务模板。
在 PowerShell 中进入插件目录,安装依赖并构建。
Set-Location "$env:USERPROFILE\.screenpipe\pipes\notion"
npm install
npm run build
重启兼容版 Screenpipe,检查插件列表,并在未启用时启用 notion。
screenpipe pipe list
screenpipe pipe enable notion
下面是原部署中的构建和插件列表截图。构建输出结束后,列表中能看到 notion 和启用状态。
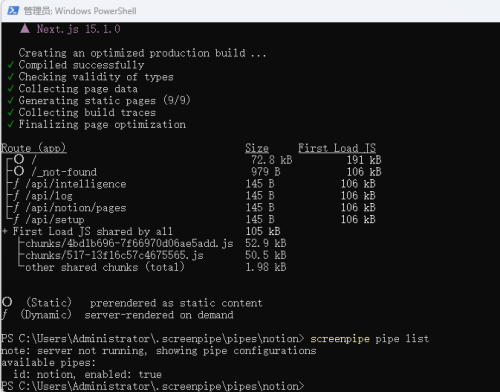
如果当前版本提示不支持这组命令,回到版本与插件机制的选择,别把新版 pipe.md 和旧版 pipe.json 混在一个目录里碰运气。
让插件有地方写日志
准备三个 Notion 页面
这份方案使用 Activity Logs、Relationship Intelligence 和工作日志中心。模板入口放在本文网站页面开源资料:https://zhcmqtt.top/article/daily-report,复制到自己的工作区后再连接插件。
| 页面或数据库 | 用途 | 是否由插件直接写入 |
|---|---|---|
| Activity Logs | 保存标题、描述、标签及活动起止时间 | 是 |
| Relationship Intelligence | 保存联系人、沟通主题与跟进建议 | 是,使用单独的分析任务 |
| 工作日志中心 | 组织日报、周报等汇总页面 | 本文用 Notion AI 指令整理 |
插件的连接界面需要前两个数据库。即使你主要关心日报,也要把连接字段填齐;工作日志中心用于后续汇总,不填进活动日志的 Database ID。
创建集成,授权到正确的数据库
在 Notion 的集成管理中创建内部集成,选择对应工作区,取得 Internal Integration Secret。
授予插件读取、插入和更新内容所需的权限,并将 Activity Logs 与 Relationship Intelligence 加入该集成的可访问范围。
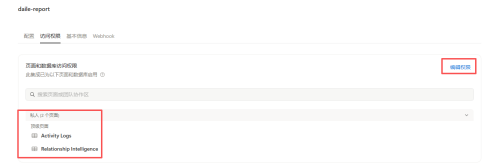
这两个动作都要做。拿到密钥,只解决了「是谁」;数据库授权,才决定它能访问哪些页面。配置和演示截图中的密钥应保持遮挡。
还要留意数据库格式。项目使用 Notion SDK 2.x 的数据库接口;Notion 新 API 引入了 data source。复刻时保留对应依赖和单数据源数据库,不能只升级 SDK、其他调用全不改。
打开插件,填写连接信息
启动 Screenpipe 和插件后,在 Windows 上打开本地配置页面。
Start-Process 'http://localhost:44719'在 Connection 中填写集成密钥,选择 Activity Logs 和 Relationship Intelligence,点击 Connect Notion,再保存设置。
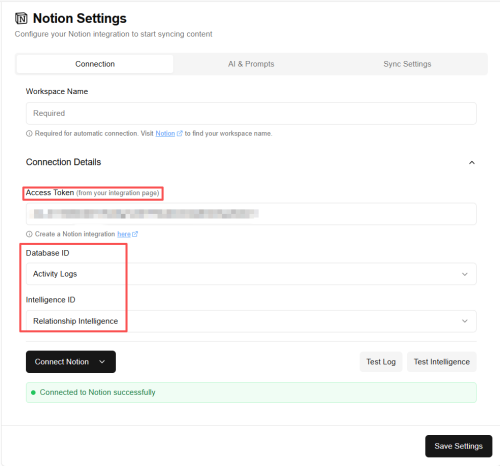
连接校验会更新这两个数据库的标题和字段。 初次配置使用专门复制的模板库,避免将无关业务数据库选进来。
活动日志的标题字段需要叫 Name,这是写入代码使用的名称。其他字段包括 Description、Tags、Date、StartTime、EndTime 和 Summary。如果更换了模板,字段名与类型也要对齐,中文显示名不能随意替换这些接口字段。
把模型、提示词和执行间隔调对
在 AI Prompts 中创建或选择 Ollama 预设,填写本机兼容接口和模型名称。下面的配置图使用 qwen2.5:latest。
项目包含一份 daily-report-cn.json 提示词配置。它定义了中文日报的写作方向,但插件实际写入 Activity Logs 的结果仍是 title、description、tags 这三个字段;提示词文件本身不会自动建立整套日报和周报数据库。
我更愿意先让每条活动日志写具体。知道它在说哪份文件、哪段讨论、哪个问题,汇总时才有抓手。
下面是一段可用于活动日志的 Custom Prompt 示例。
请根据本次采集到的屏幕文字和音频转写,整理一条中文工作日志。
写清涉及的项目、应用、文件及具体动作,只描述输入中能找到的事实。
区分查阅、编辑、调试与已经完成的结果。
没有明确证据时,不推测完成状态,不估算工时,不编造修复数量。
保留有用的项目名称与检索标签,让后续日报能够找到原始记录。
插件会把这段要求放入自己的生成提示中,再要求模型返回规定的 JSON 结构。先保持这个结构稳定,日报的长篇排版留给后面的汇总环节。
间隔和数据窗口,要一起看
Sync Settings 里有长期任务间隔、短期任务间隔、Page Size 和去重开关。
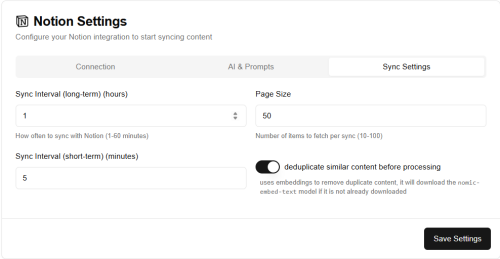
| 设置 | 当前默认配置或实现 | 实际作用 |
|---|---|---|
| 短期任务 | pipe.json 默认每 5 分钟调用 /api/log |
生成活动日志 |
| 长期任务 | pipe.json 默认每 1 小时调用 /api/intelligence |
分析沟通关系,生成跟进建议 |
| Page Size | 默认 50 条 | 限制单次查询的数据条数 |
| 去重 | 可选,使用 nomic-embed-text |
在当次数据中减少相似内容 |
这里有个容易忽略的细节。/api/log 当前使用的查询起点是下面这样。
const now = new Date()
const oneHourAgo = new Date(now.getTime() - minute(1))
变量叫 oneHourAgo,实际减掉的却是 1 分钟。
默认每 5 分钟执行一次,每次只查最近 1 分钟,两次查询之间就会留下约 4 分钟的间隙。把短期任务改成 1 分钟可以减少这种间隙;如果要按 5 分钟收集,就需要同时修改查询时间窗口,并考虑执行延迟、停机补采和重复记录。
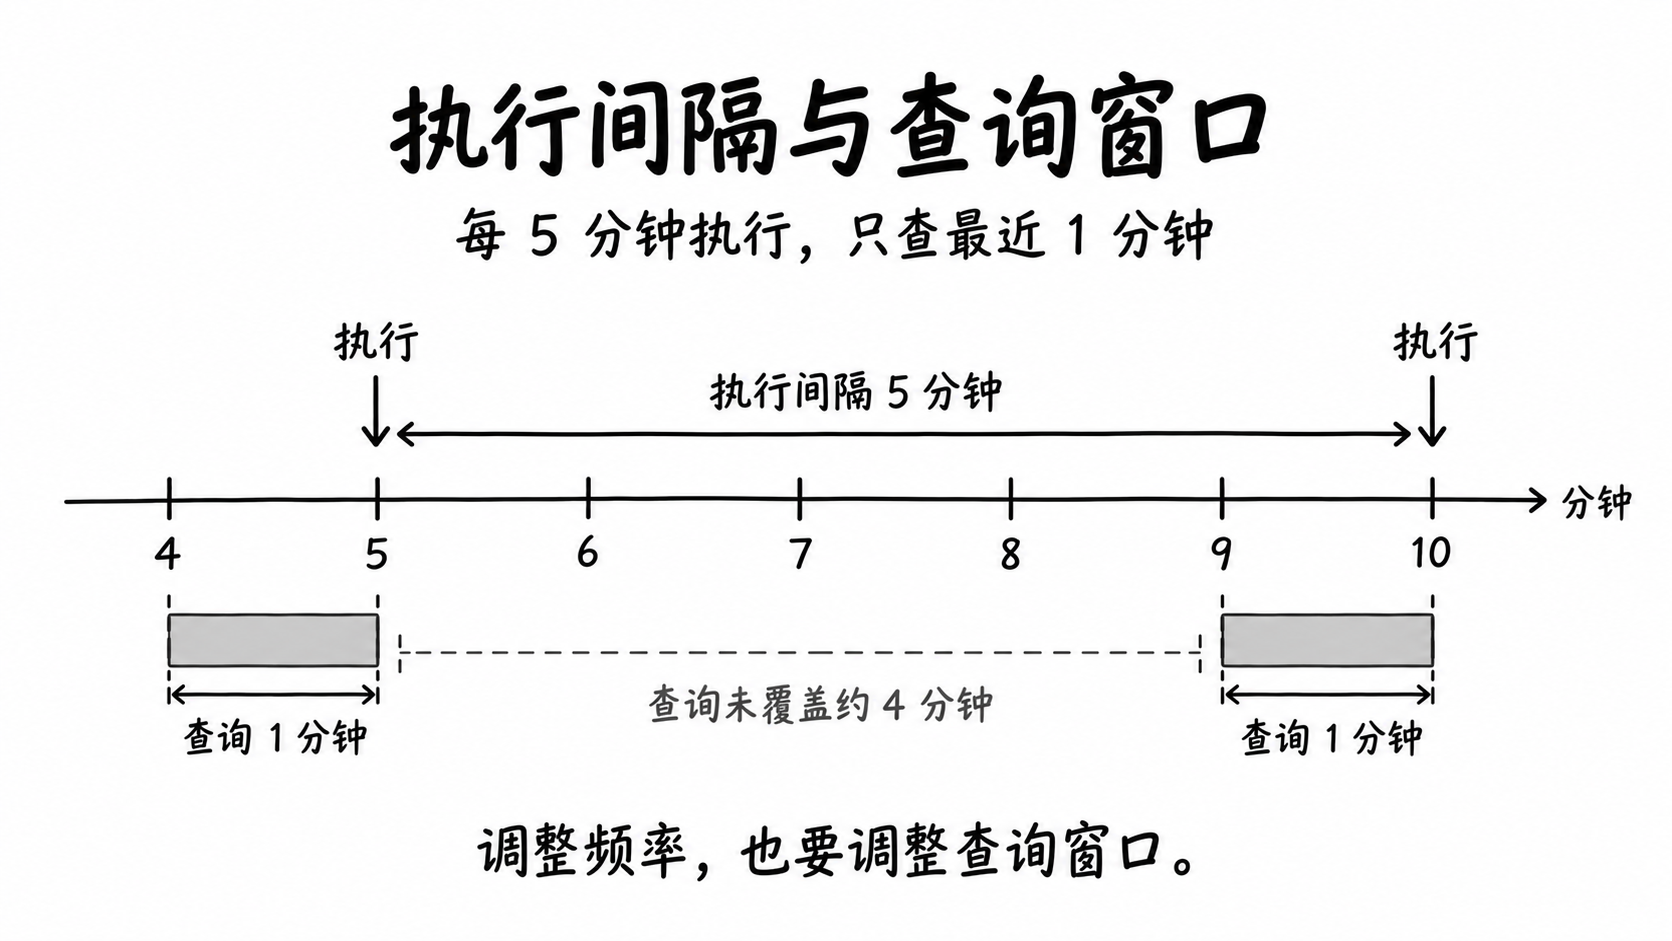
这份实现尚未做完整的断点补采。电脑关机、任务失败,以及超过 Page Size 的数据,都需要另外处理。把频率设置好,是工作日志完整的起点,不能靠一句「全自动」跳过。
去重也有自己的范围。它只比较当次查询中的数据,不会自动清理 Notion 里已经写入的历史条目。开启前确认 nomic-embed-text 已就绪;遇到向量生成失败时,程序会保留原数据继续处理。
Windows 上调整执行间隔后,还要确认真正运行的 pipe.json 已更新。程序优先读取 SCREENPIPE_DIR,其次读取 HOME,都没有时回退到当前工作目录。使用自定义数据目录时,将 SCREENPIPE_DIR 指向实际的 .screenpipe 根目录。
真正检查一次写入
保存设置,让 Screenpipe 产生近期记录,再点击 Test Log。到 Activity Logs 中查看是否出现新的标题、描述、标签和起止时间。
本地页面能打开、插件端口在监听、Notion 连接通过,是不同的检查。新日志确实写进了数据库,才接上了采集、分析和归档这几棒。
常见的失败也可以沿着这条顺序找。
| 现象 | 先检查哪一段 |
|---|---|
| 没有近期屏幕数据 | Screenpipe 采集状态、查询窗口、当时是否有活动 |
| 提示没有 AI preset | 已保存的日志模型预设或默认预设 |
| 模型接口报错 | 本机服务、/v1 地址、模型名称及结构化输出支持 |
| Notion 无权访问数据库 | 集成的访问范围与两个数据库 ID |
| 写入提示字段不匹配 | Name 等字段名称与类型 |
开机时,少点几次启动按钮
几个服务配置好之后,每次开机都手动找一遍也挺机械的。项目里的 Start-Screenpipe.bat 把启动动作放到了一起。
它依次处理四件事。
- 扫描数据目录中的
.mp4,保留文件名包含今天或昨天日期的文件,删除其他匹配的视频文件。 - 检查
ollama.exe进程,没有时启动ollama serve。 - 从指定路径启动
screenpipe.exe。 - 等待
44719端口进入监听,最多检查 20 次,两次之间等待 2 秒。
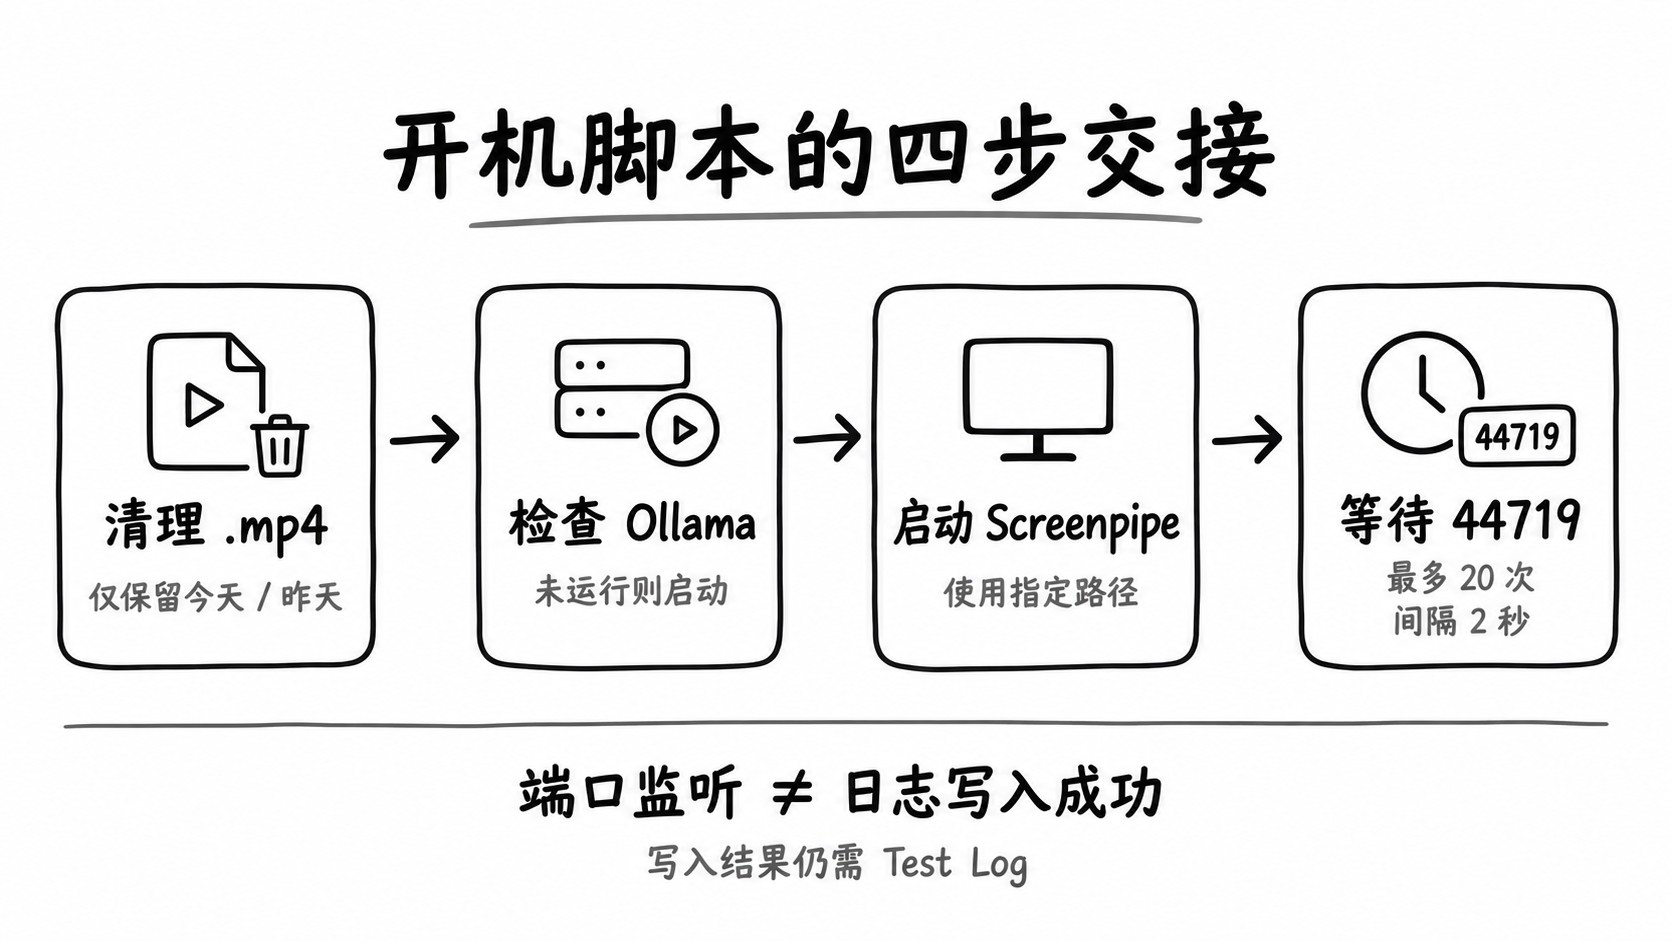
使用前修改 User_name,并确认数据目录与可执行文件路径。在这份脚本里,它们都是写死的 Windows 路径。
清理规则依赖文件名包含 YYYY-MM-DD,并会真的删除文件。 如果你的录屏采用其他命名方式,先停用清理部分再核对。它只处理该目录里的 .mp4,没有同步删除数据库记录或其他音频文件,也没有递归清理子目录。
把路径和清理范围确认好后,可以给脚本创建桌面快捷方式。需要开机自动运行时,再把快捷方式放入 Windows 用户启动目录;可通过运行框输入 shell:startup 打开它。
日报和周报,在 Notion 里收束
活动日志积累起来之后,打开工作日志中心。在 Notion AI 的说明中设置日报或周报助手,告诉它使用哪张源数据库、筛选什么日期,以及结果应写入哪张数据库。
日报可以从这样的要求开始,数据库名称替换为你工作区里的实际名称。
读取 Activity Logs 中指定日期的活动记录,生成一份中文日报。
按项目归类,写清具体动作、能够确认的结果、遗留问题和下一步。
保留日期与来源记录;重复记录合并,缺少依据的成果和工时不要补写。
将结果写入工作日志中心的每日工作日报数据库。
已有同日页面时先检查,避免重复创建。
随后在对话里输入「帮我完成今日日报」。生成后检查它选中的日期、读取的记录和目标页面。下面的演示显示了查询活动日志、生成日报与保存页面的过程。
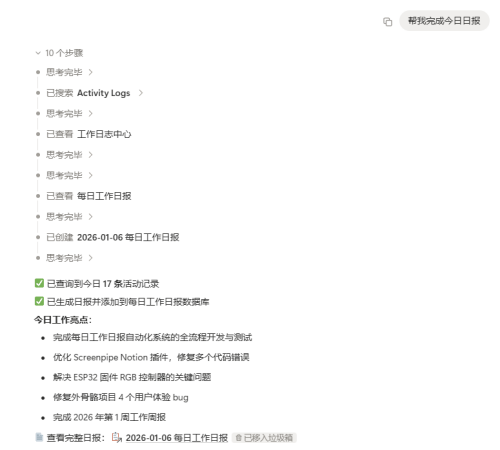
周报再往上一层。输入「帮我完成本周周报」时,最好给出明确的起止日期,要求它汇总对应的日报,而不是把七天的内容重新猜一遍。Notion AI 能否读取和写入这些页面,也取决于当前工作区的功能与访问权限。
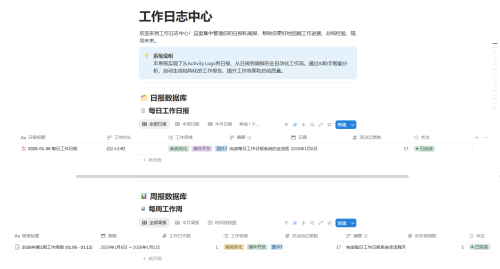
这套使用方式是自动积累活动日志,再由指令触发汇总。想让日报到点自行生成,还需要另设定时汇总任务;当前插件配置的长期任务是关系分析,不能直接拿它当每晚日报定时器。
存下来的内容是什么样
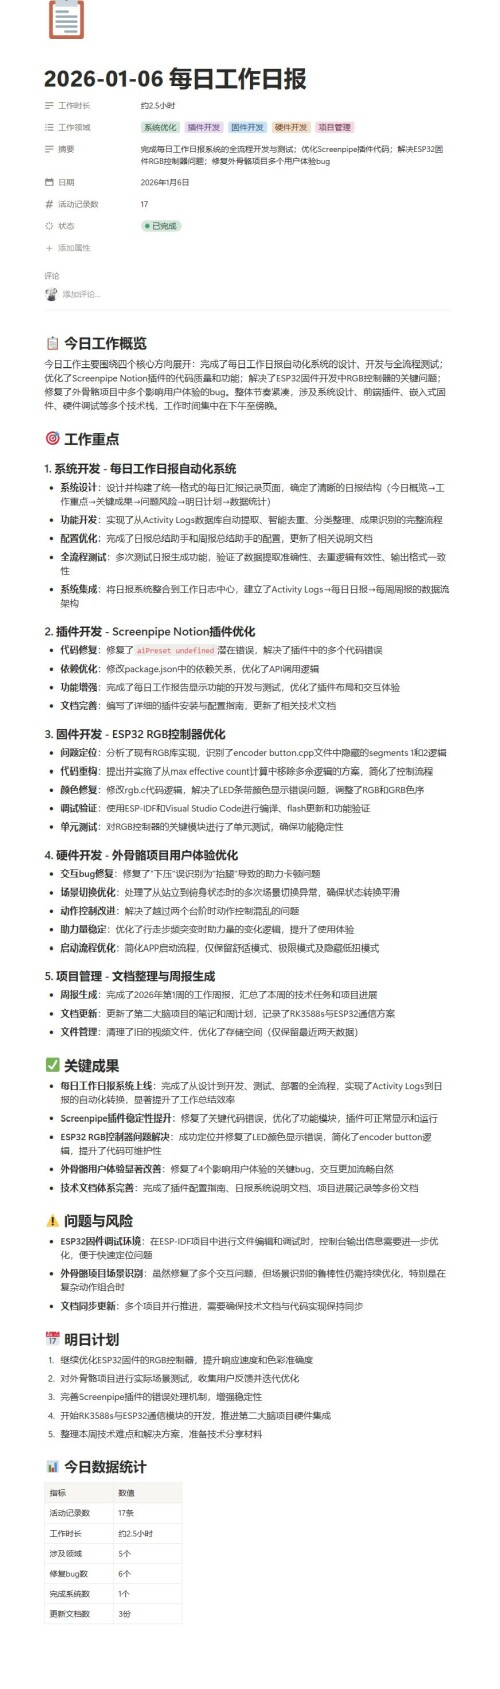
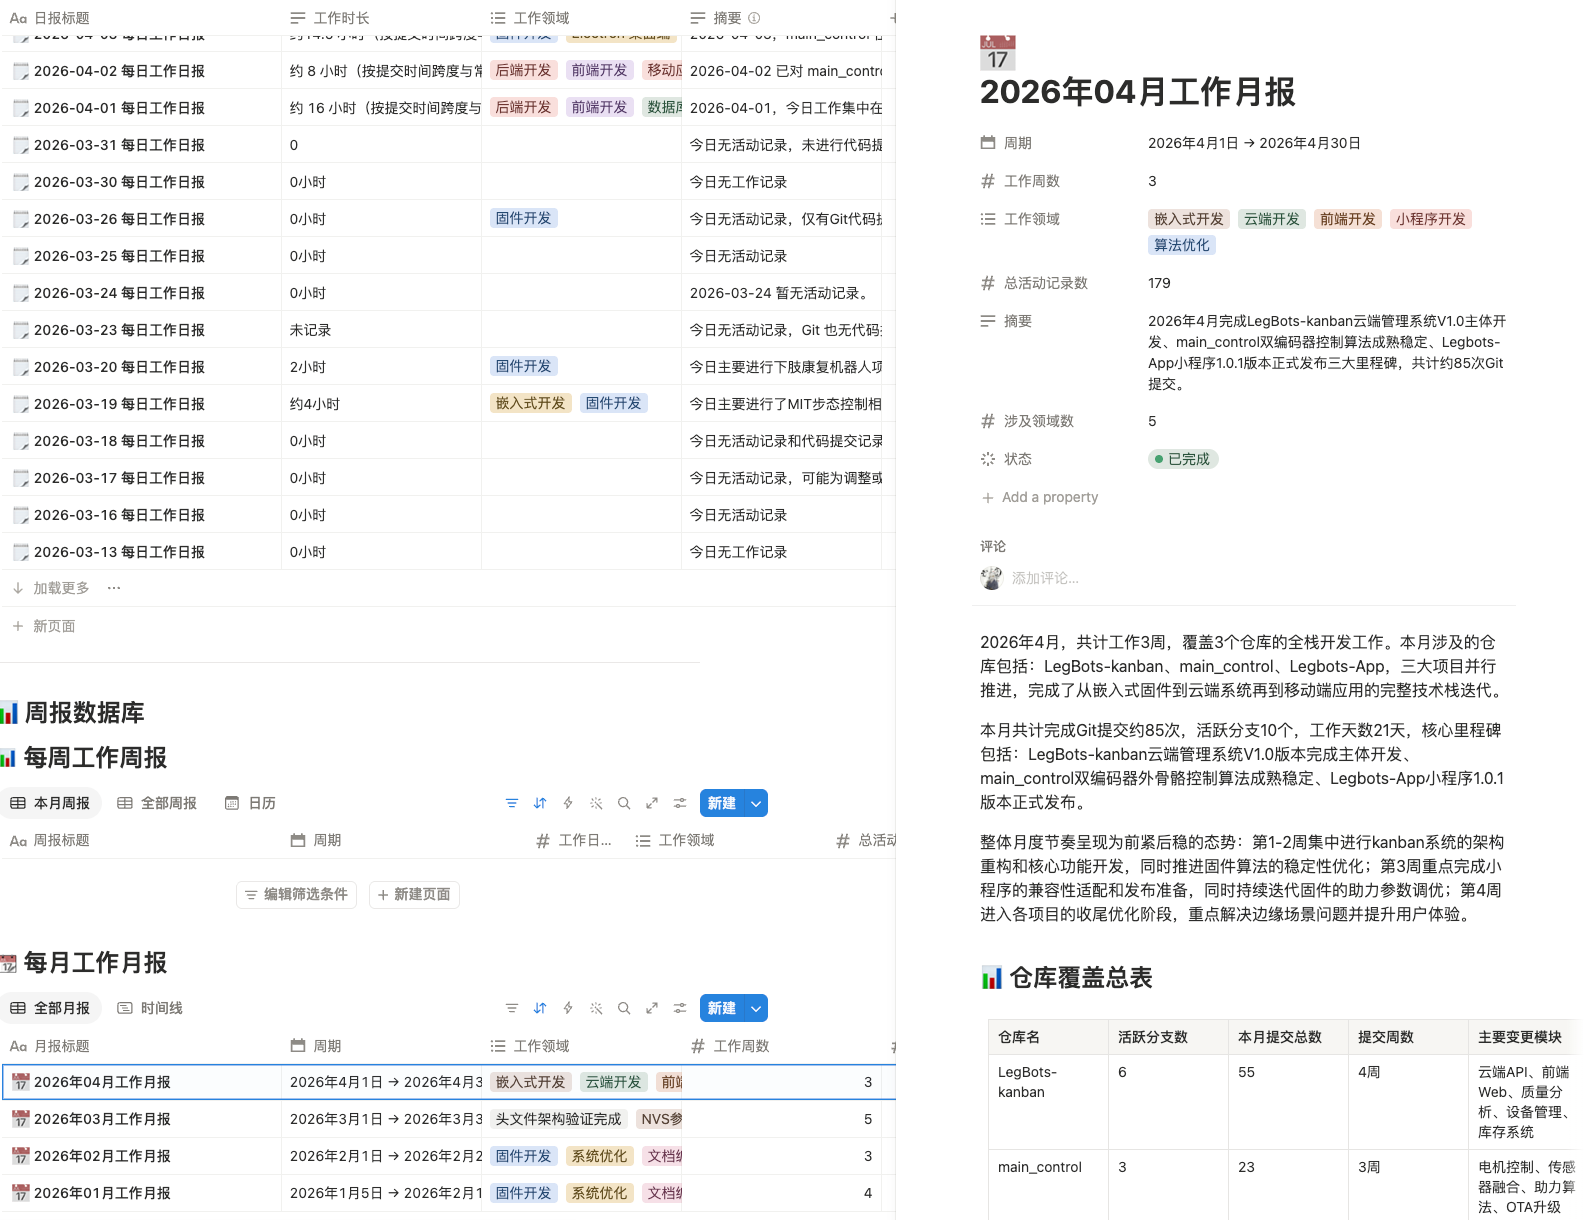
下面是已有使用记录中的五张归档图。先看单篇日报和周报,再看后续记录积累起来之后的列表与月报。它们展示页面组织方式,截图中的统计数字仍应回到实际记录核对。
日报把工作概览、项目重点、问题和下一步放在同一页。
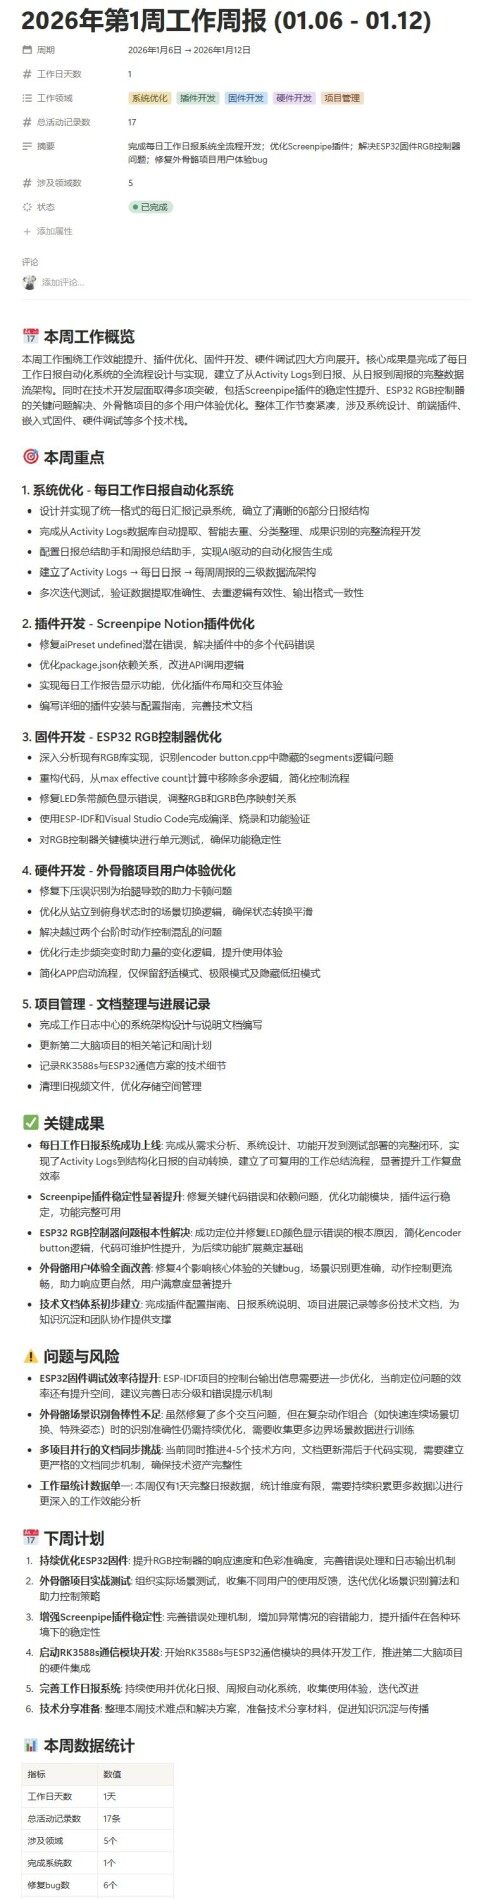
周报继续汇总项目进展与遗留事项。截图中的周期和有效记录天数,需要分别检查;一份周报不一定覆盖了完整一周的数据。
后续的日报列表可以与单篇页面并排打开,按日期回看具体项目。
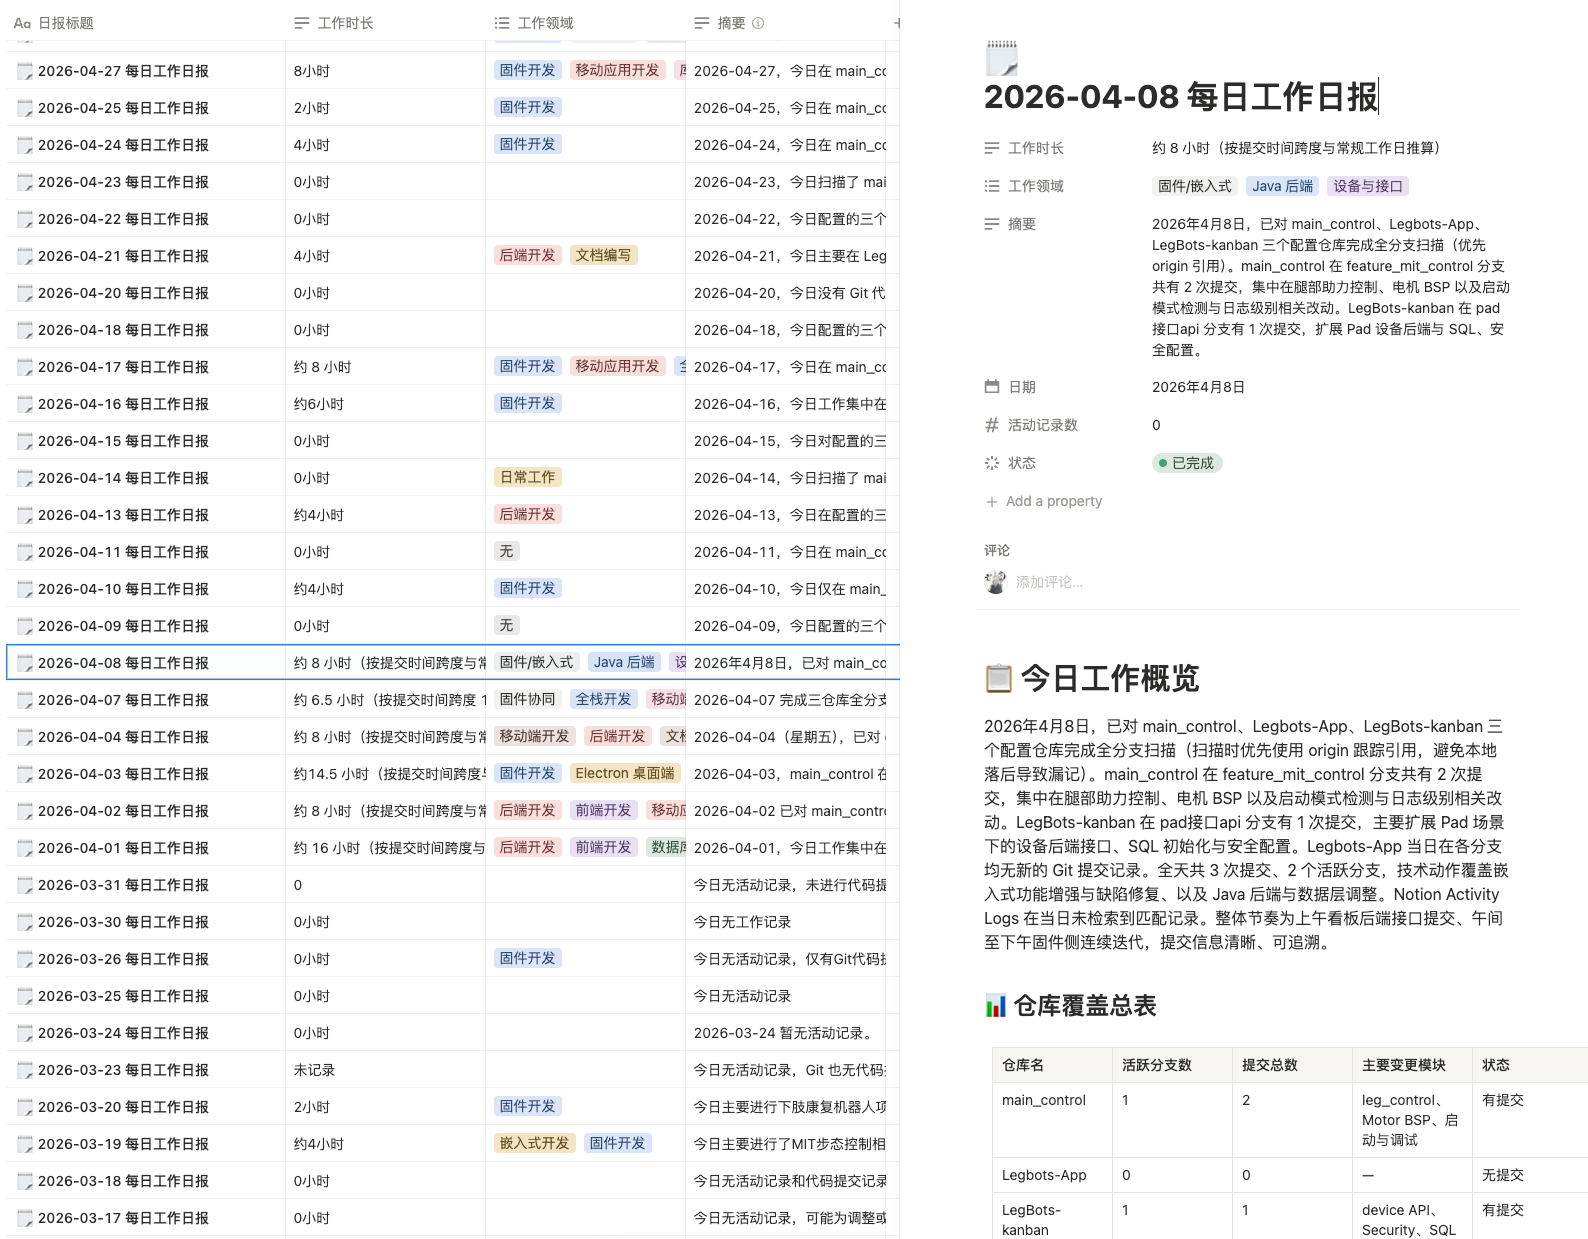
这里的扩展记录还包含 Git 仓库提交信息。这需要额外的仓库数据输入,这份插件没有自行扫描 Git 仓库的实现;复刻基本链路时,不要把截图里的所有数据来源都算到 Screenpipe 身上。
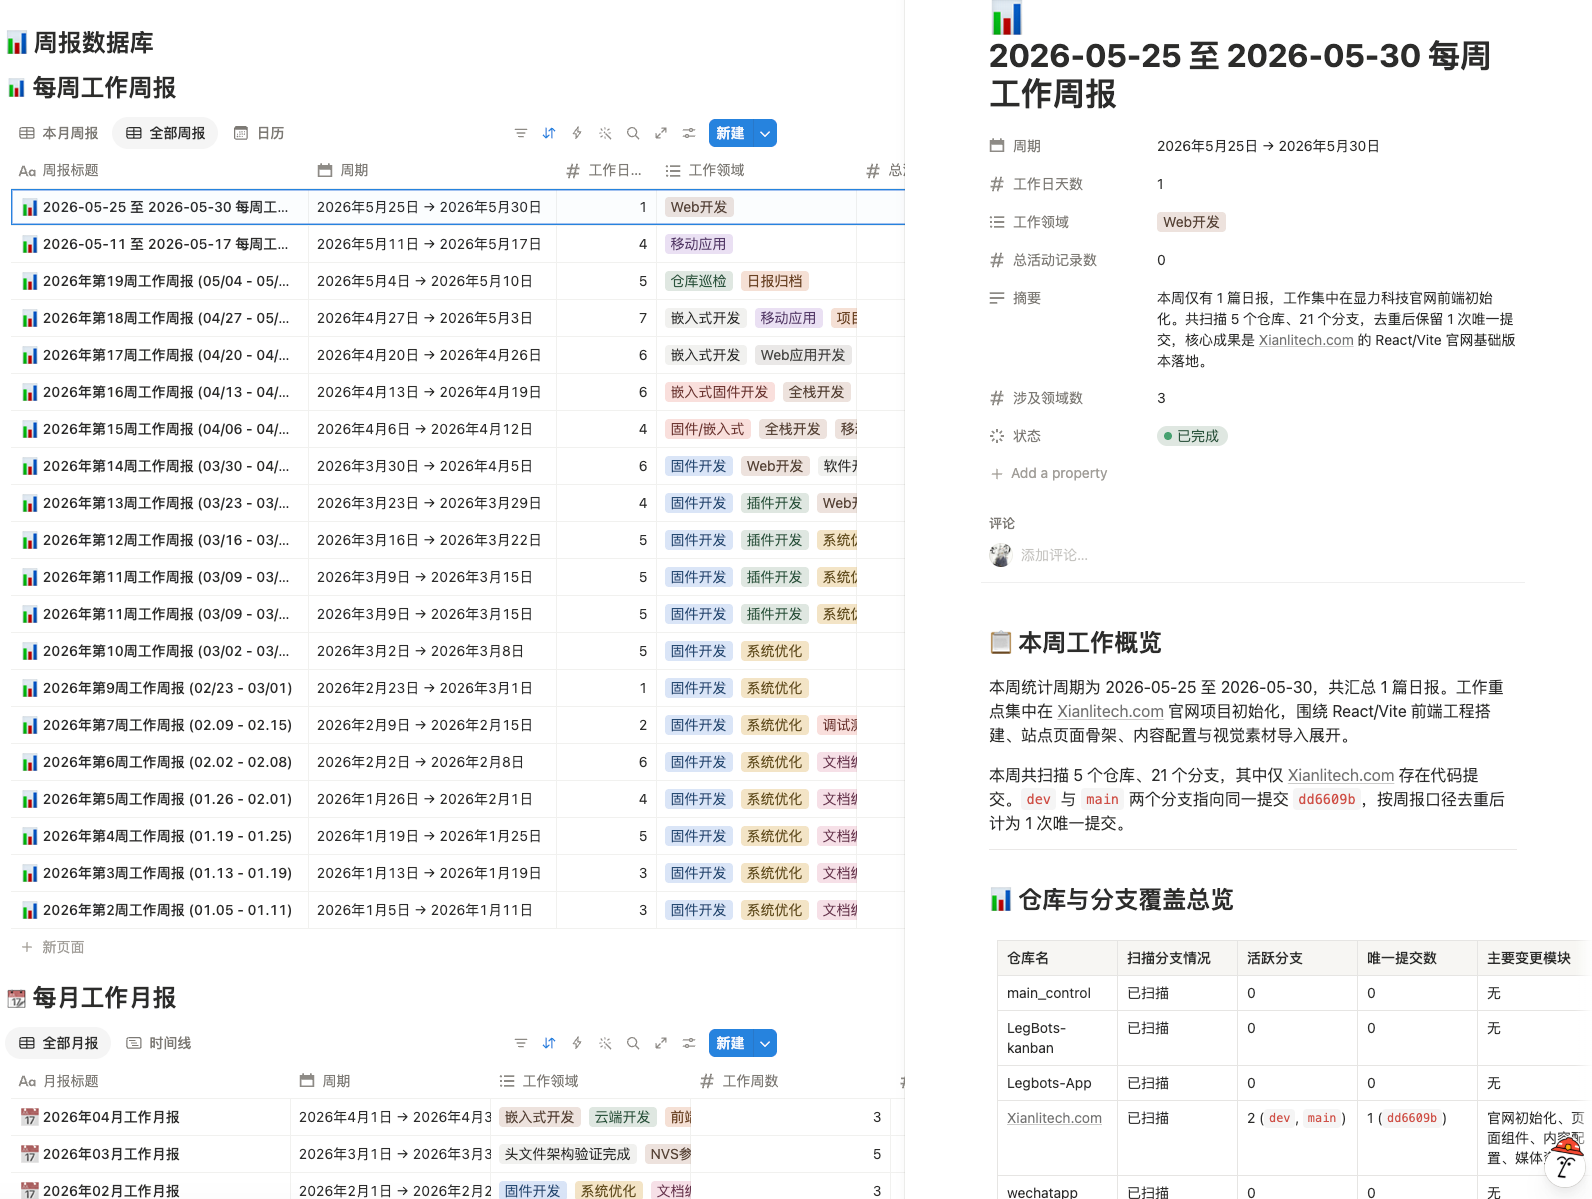
月报也是在已有记录上继续汇总的示例,需要另设汇总指令或任务,不是当前插件定时配置里的第三种输出。
让记录接得上,回头才找得到
我更看重这套流程留下的线索。看过什么文件,围着什么问题调试,哪一天又回到了同一个项目,能从记录里找回来,日报就有了落点。
模型负责整理,日期、完成状态和关键结果仍然值得亲自看一眼。采集窗口没覆盖的工作,也可以补一条手记,别让系统把「没有记录」写成「没有做事」。
把重复的事交给机器,把好奇留给自己。
下班前再打开那页日报,至少不用从一个空白输入框里,重新拼出整整一天。
参考资料
Screenpipe 新版 Scheduled tasks(与本文旧插件机制不同)
鸿尘客 Honchic · 把脑洞焊到电路板上