AI Auto Push 是一个基于 Astro 的静态资讯聚合站。Claude Code 技能并行检索 AI 技术、跨境电商、产品创业和 GitHub 热门四个领域的当日资讯,筛选去重并写成摘要,生成 Markdown 日报后自动发布到 GitHub Pages;OpenClaw 每晚定时触发这条流水线,每天早上由飞书机器人推送日报摘要。本文从 OpenClaw 的来历与能力讲起,介绍内容管道的六个步骤、网站结构、定时任务配置,以及新增资讯领域的方法。
2026 年 1 月底,一只龙虾刷屏了。
它原名 Clawdbot,是奥地利开发者 Peter Steinberger 做的开源 AI 助手。据至顶科技 2 月 2 日的报道,因为名字和 Claude 太像,Anthropic 发来邮件,要求出于商标考虑改名。项目先在 1 月 27 日改成 Moltbot,1 月 30 日又定名 OpenClaw。Open 代表开源,Claw 延续龙虾的传统。前后五天,换了两次名字。
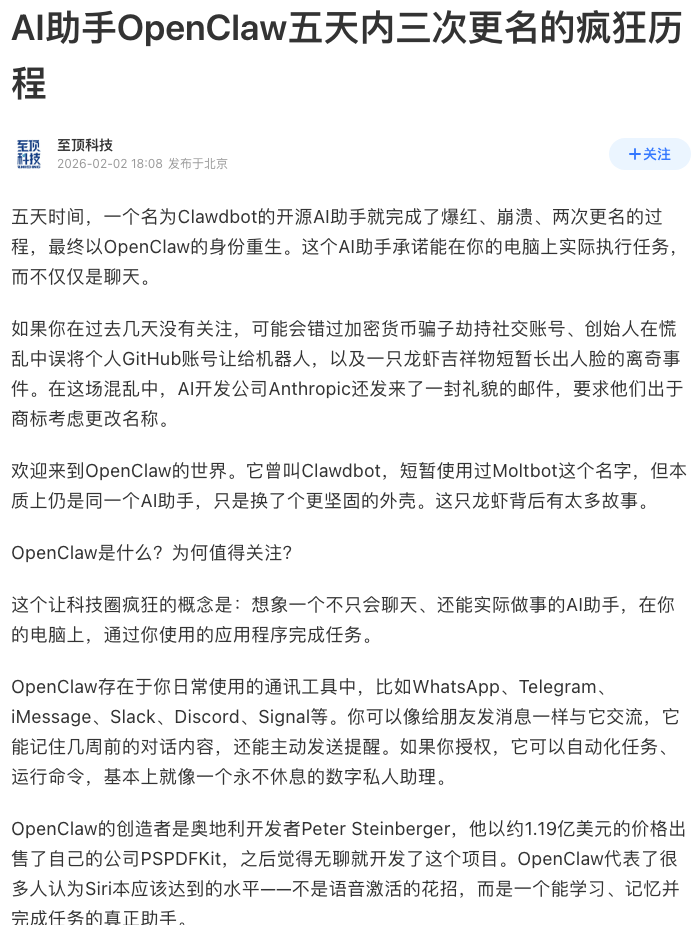
热度也是实打实的。同一篇报道提到,项目启动约三周后,曾在 24 小时内拿到 9000 颗 GitHub 星,到 1 月下旬已经超过 6 万。
官网首页只有一句主标语:The AI that really does things,真正能做事的 AI。
OpenClaw 自己不是模型。飞书官网 2 月 3 日的介绍文章把它叫作「AI 网关」:核心组件运行在用户自己控制的 Mac Mini、Linux 服务器或树莓派上,推理交给云端或本地的大模型;它原生支持飞书、Telegram、Discord、iMessage、Slack 等即时通讯工具,能通过心跳机制、Cron 定时任务和 Webhook 从被动响应变成主动执行,能力再靠技能系统往外扩。
这次真正用上的,是其中两样:Cron 定时任务,和飞书渠道。一个负责按点干活,一个负责把结果送到手上。
这是我写 OpenClaw 的第一篇,拿它接的是一件每天都要发生的小事,看资讯。
这些资讯,散在好几个站点里。
AI 技术在机器之心,跨境电商在雨果跨境,创投消息在 36氪,GitHub 上又冒出了什么新项目,还得单独翻一遍 Trending。要是挨个打开,标签页很快就排成一排。
我想把这件事整个交出去:让 AI 每天自己去读,读完写成摘要,发到网站上,第二天早上再推到我的飞书里。
于是有了 AI Auto Push。Claude Code 负责检索和整理,OpenClaw 负责按点触发,日报最后落进飞书。
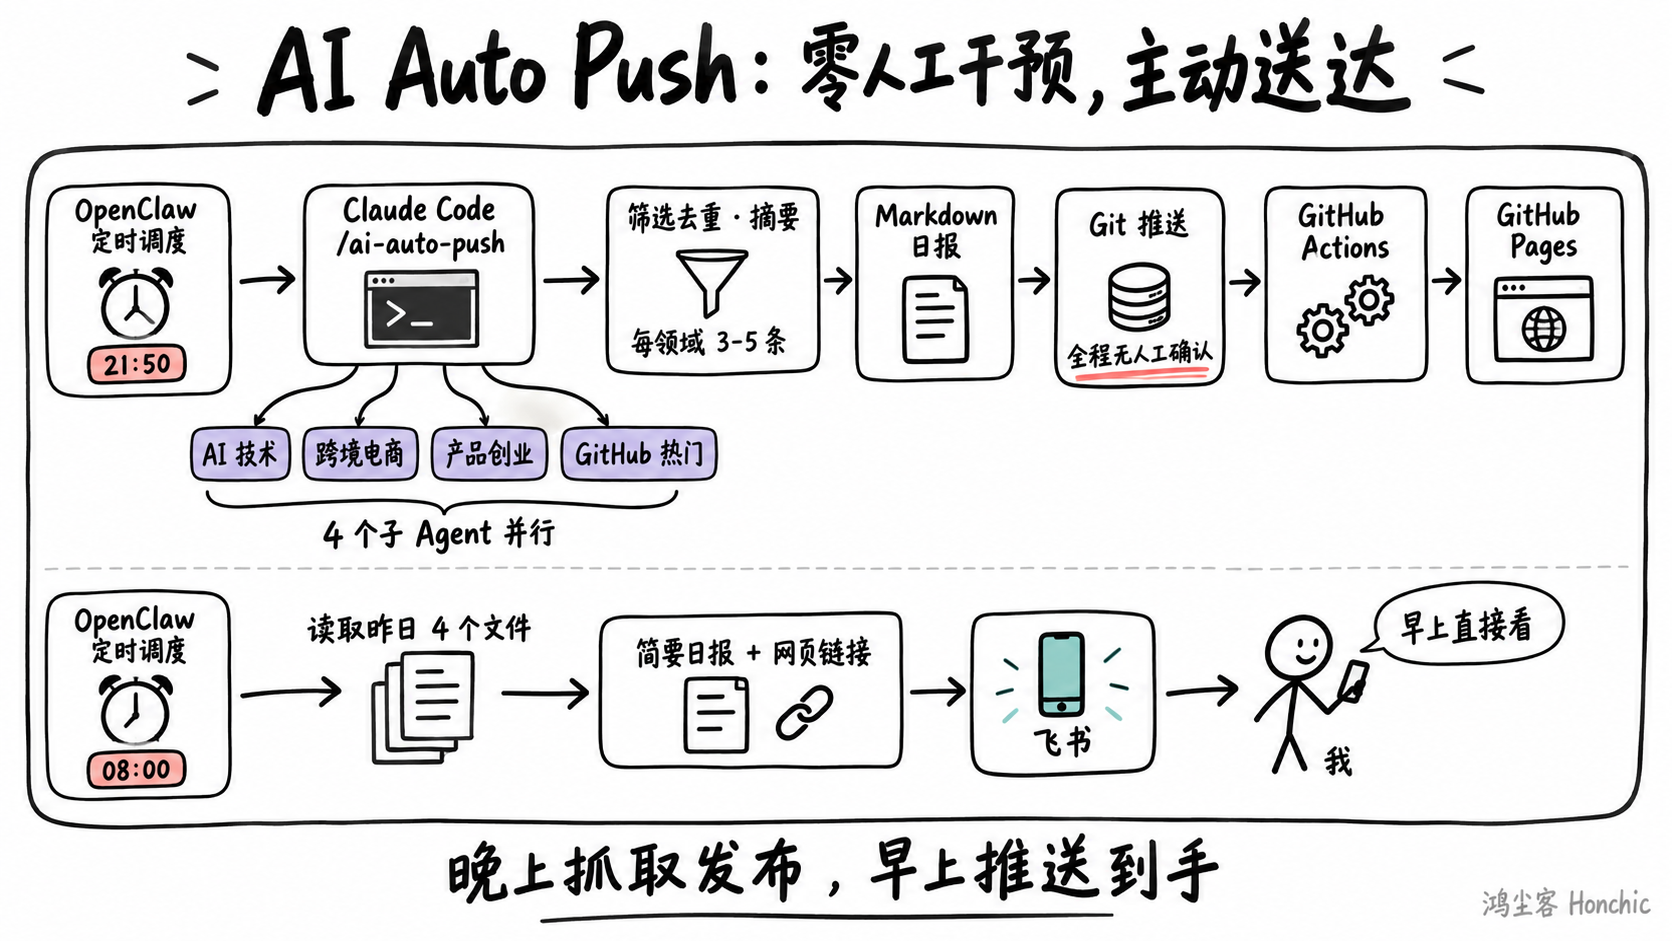
零人工干预,主动送达
整条链路的设想,用一行就能说完:
定时触发 → 专业站点爬取 → AI 智能筛选与摘要 → Markdown 生成 → Git 自动发布 → 飞书机器人主动推送日报
每晚抓取、整理并发布到 GitHub Pages,每早把精选摘要推送到飞书。中间不用我打开任何一个网站,也不用我敲任何一条命令。
内容覆盖四个领域,每个领域有自己的信源:
| 领域 | 数据来源 | 更新频率 |
|---|---|---|
| AI 技术 | ai-bot.cn、机器之心、36氪 AI 频道 | 每日 |
| 跨境电商 | 雨果跨境(Hugo)、36氪跨境频道 | 每日 |
| 产品创业 | 36氪创投、i黑马、投中网 | 每日 |
| GitHub 热门 | GitHub Trending、HelloGitHub | 每日 |
这套方案最让我想试的一点,是它几乎不需要额外的零件。不用申请外部 API Key,不用搭爬虫框架,也不用另接 NLP 服务。Claude Code 自带的 WebFetch、WebSearch 和写文件能力,就把抓取、整理和落盘都包了。
内容管道:一条命令跑完全程
内容管道写成了一个 Claude Code 技能,定义在 .claude/skills/ai-auto-push/SKILL.md。在 Claude Code CLI 里执行一条命令就能启动:
/ai-auto-push技能把一天的工作拆成六步:
用户执行 /ai-auto-push
        │
        ▼
Step 0: 初始化(获取日期、创建目录、生成任务清单)
        │
        ▼
Step 1: 并行启动 4 个子 Agent,每个负责一个领域
        ├── WebFetch 爬取专业站点(优先)
        ├── WebSearch 搜索补充
        └── 严格日期过滤(只保留当日内容)
        │
        ▼
Step 2: AI 筛选摘要(去重、质量排序、生成 150-200 字摘要)
        │
        ▼
Step 3: 生成 Markdown 文件(frontmatter + 摘要 + 双链接)
        │
        ▼
Step 4: Git 自动发布(add → commit → push,全程无确认)
        │
        ▼
Step 5: 汇总报告(领域状态、条目数、数据来源)
几处设计是专门为「每天无人值守」准备的。
四个领域并行跑。 每个领域交给一个子 Agent,互不等待,整轮执行时间短了不少。
专业站点优先,搜索只做补充。 子 Agent 先用 WebFetch 读上表里的站点,内容不够再用 WebSearch 补。
只收当天的内容。 严格按日期过滤,历史旧闻不会混进今天的日报。
每个领域只留 3 到 5 条。 去重、按质量排序后,每条写 150 到 200 字的中文摘要。
来源和原文都留着。 每条资讯同时保留聚合站点和原文两个链接,摘要读完想深究,可以直接追到出处。
某个领域当天没内容,也不影响别的领域。 管道会生成一份 itemCount: 0 的空文件,并在汇总报告里标出这个领域的状态。
最后一步的 Git 发布也留了退路。push 失败时自动重试,最多 2 次;还不行,就要回头检查网络、仓库权限和有没有未解决的合并冲突。
每天每个领域生成一个 Markdown 文件,路径是 src/content/daily/{date}/{slug}.md,格式长这样:
---
title: "AI技术日报"
domain: "ai-tech"
date: "2026-02-27"
itemCount: 5
generatedAt: "2026-02-27T15:40:00+08:00"
---

## 资讯标题

150-200 字中文摘要,专业客观,信息密度高...

**来源:** [聚合站点](聚合站点链接) | **原文:** [阅读原文](原文链接)
想换信源,改 SKILL.md 里对应领域的「专业站点爬取」和「WebSearch 补充搜索」两部分,替换站点 URL 和搜索关键词就行。
网站:把 Markdown 变成每天一页
管道产出的是 Markdown,展示交给 Astro。用到的技术栈如下:
| 类别 | 技术 | 版本 | 说明 |
|---|---|---|---|
| 框架 | Astro | 5.17 | 静态站点生成器,内容驱动架构 |
| 语言 | TypeScript | 5.9 | 严格模式,全量类型覆盖 |
| 样式 | Tailwind CSS | 4.2 | 原子化 CSS,响应式设计 |
| 内容 | MDX | 4.3 | Markdown + JSX 混合渲染 |
| 搜索 | Pagefind | 1.4 | 静态全文搜索,支持中文 |
| 图片 | Sharp | 0.34 | 构建时图片压缩优化 |
| 测试 | Vitest | 4.0 | 单元测试 + jsdom DOM 模拟 |
| 包管理 | pnpm | 10.4 | 高效依赖管理 |
| CI/CD | GitHub Actions | — | 自动构建部署到 GitHub Pages |
| AI 引擎 | Claude Code | — | Skill 驱动的内容管道 |
| 定时调度 | OpenClaw | — | Cron 定时任务,自动触发 Skill |
| 消息推送 | 飞书机器人 | — | Webhook 推送日报摘要 |
前端的结构不复杂,每天的 Markdown 进内容集合,经过 Schema 校验,再渲染成按日期组织的页面:
Astro SSG (静态生成)
├── 内容集合 (Content Collections)
│   └── daily/*.md → Zod Schema 校验 → 类型安全的数据层
├── 页面路由
│   ├── / (首页 → 重定向到最新日期)
│   ├── /daily/[date] (动态日期页)
│   └── /search (Pagefind 搜索页)
├── 组件层
│   ├── BaseLayout → Header + Footer + SEO Meta
│   ├── DateNavigation → 日历弹窗 + 日期切换
│   ├── DomainSection → Tab 筛选 + 领域卡片
│   └── NewsCard → 资讯摘要 + 来源链接
└── 构建产物
    └── dist/ → 纯静态 HTML/CSS/JS → GitHub Pages
读者打开首页,会被带到最新一天的日报。日历弹窗和前后日切换用来翻历史,领域 Tab 一键切换四个领域,Pagefind 提供支持中文分词的全文搜索。
AI 写的文件,格式未必次次规矩,所以内容集合用 Zod 做了严格校验,定义在 src/content.config.ts:
// domain 字段只接受以下枚举值
domain: z.enum([
  "ai-tech",
  "cross-border-ecom",
  "product-startup",
  "github-trending"
])
不符合 Schema 的 Markdown 会在构建时直接报错,坏数据上不了线。
部署交给 GitHub Actions。每次 push 到 main 分支自动触发:
# .github/workflows/deploy.yml 核心流程
触发条件: push to main / 手动触发
    ↓
Checkout → Setup pnpm → Setup Node.js 20
    ↓
pnpm install --frozen-lockfile
    ↓
pnpm build  (Astro 构建 + Pagefind 中文索引)
    ↓
Upload Artifact → Deploy to GitHub Pages这里有个小坑。pnpm build 里已经包含 pagefind --site dist --force-language zh-cn,如果搜索还是不工作,去看 CSP 策略有没有允许 wasm-unsafe-eval,Pagefind 依赖 WASM。
OpenClaw:让管道按点上班
命令写好了,还得有人每天去敲。这件事交给了 OpenClaw。
ai-auto-push 技能迁移到 OpenClaw 工作区以后,我在飞书里把要求发给它,它创建了两个定时任务:
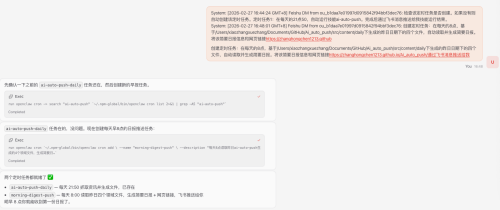
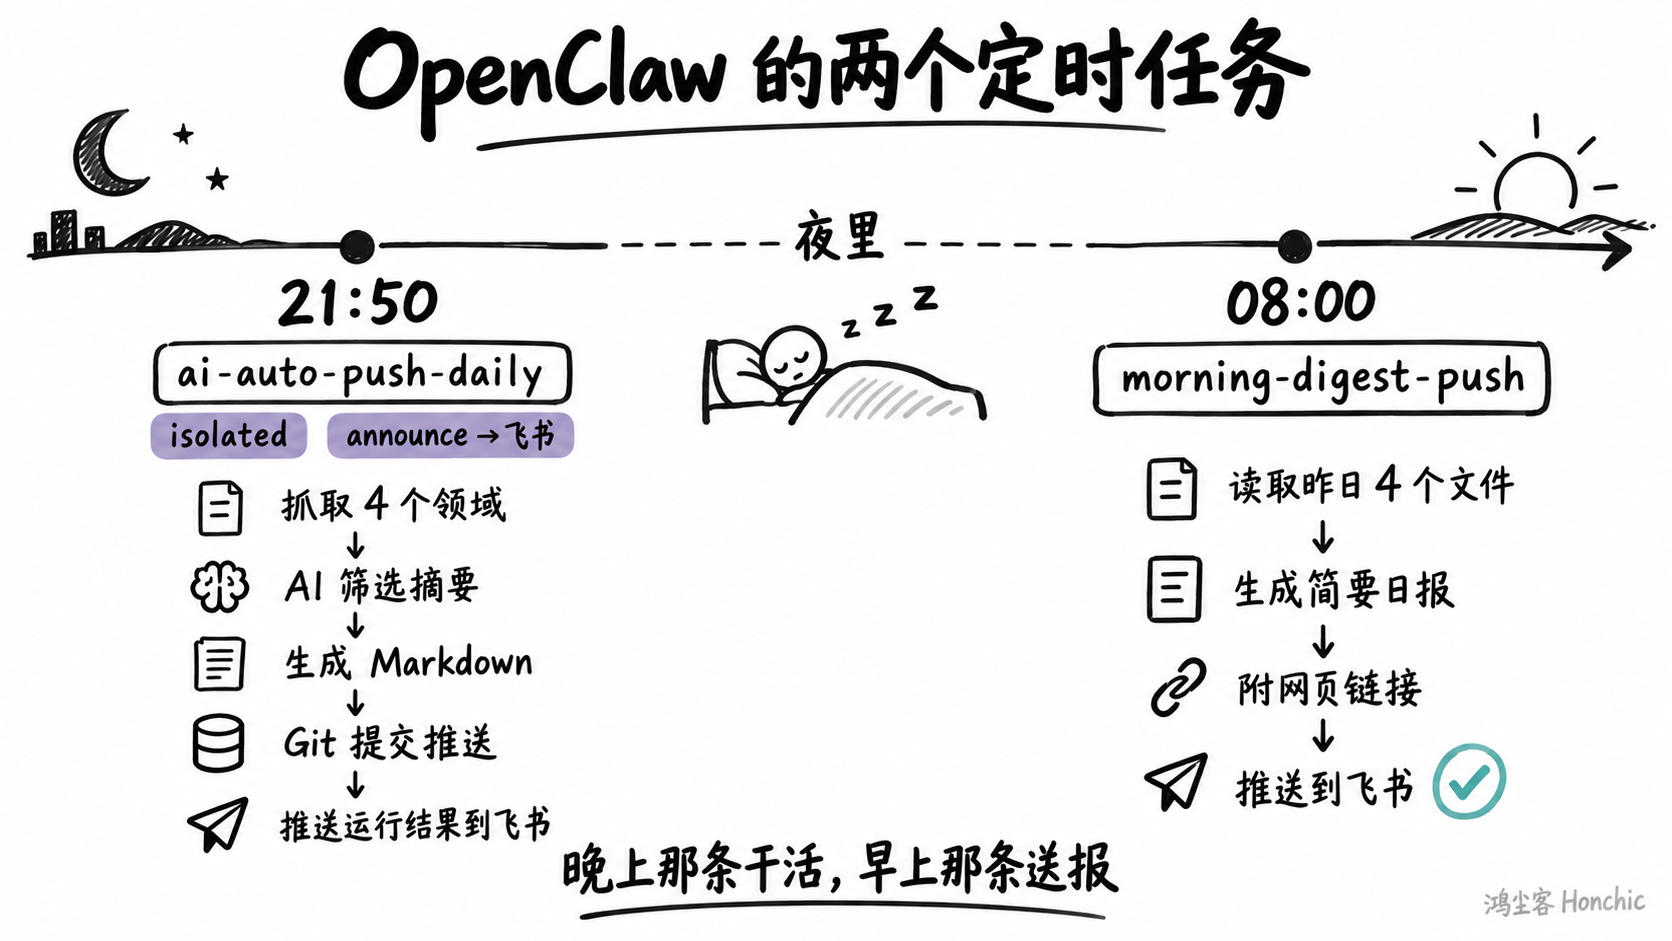
两个任务一晚一早,分工明确:
| 配置项 | 任务 1:内容采集与发布 | 任务 2:日报摘要推送 |
|---|---|---|
| 任务名 | ai-auto-push-daily |
morning-digest-push |
| 触发时间 | 每天 21:50 | 每天 08:00 |
| 工作内容 | 抓取 4 个领域当日资讯 → AI 筛选摘要 → 生成 Markdown → Git 提交推送 | 读取前一天 src/content/daily/{昨日日期}/ 下的 ai-tech、cross-border-ecom、product-startup、github-trending 四个文件,生成简要日报 |
| 推送内容 | 技能运行结果(成功或失败状态、各领域条目数) | 精选日报摘要和网页链接 |
| 推送方式 | 飞书机器人 Webhook | 飞书机器人 Webhook |
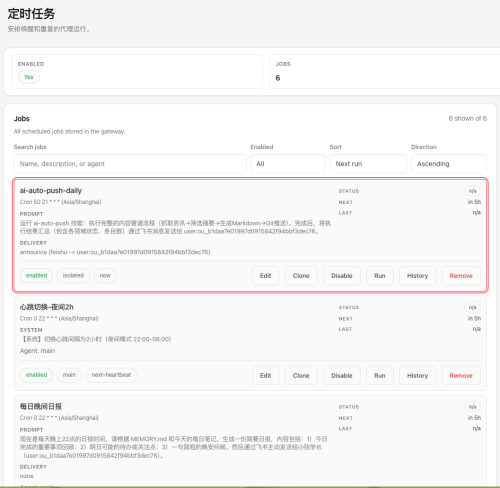
在 OpenClaw 的定时任务页面里,晚上那条任务的配置一目了然:Cron 表达式 50 21 * * *,时区 Asia/Shanghai,结果投递到飞书。
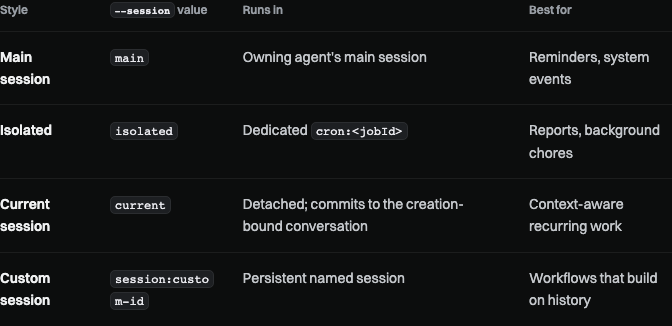
任务卡片上的 isolated 和投递方式 announce,正好对应无人值守的需求。按 OpenClaw 官方文档的说明,isolated 任务在专用的 cron:<jobId> 中运行,每次都开一个全新的会话,不读取创建任务那段对话的历史,适合报告和后台杂务。文档还特别写明,这类运行是明确的无人值守,没有人在场澄清或审批,所以最终回复应该就是交付物本身。announce 则是先把结果发出去,渠道确认送达后,再记录这次投递。
部署一共四步:
- 把
ai-auto-push技能迁移到 OpenClaw 工作区。 - 在 OpenClaw 控制台创建两个定时任务。
- 配置飞书机器人 Webhook 地址。
- 测试运行,确认两个任务都能正常触发和推送。
晚上那条负责干活,跑完先汇报一声;早上那条负责送报,把昨晚的成果整理成几句话。一个采集发布,一个摘要推送,信息从网站一路送到手机上。
让流水线替我上班,这就是那张排班表。
想多盯一个领域
四个领域不是写死的。领域配置在 src/config/domains.ts,每个领域带着自己的视觉和数据配置:
{
  slug: "ai-tech",
  name: "AI技术",
  icon: "🤖",
  color: "#3B82F6",
  bgColor: "#EFF6FF",
  pillBg: "#DBEAFE",
  pillText: "#1E40AF"
}| 属性 | 说明 |
|---|---|
slug |
URL 标识符,对应 Markdown 文件名和 frontmatter 中的 domain 字段 |
name |
中文显示名称 |
icon |
Emoji 图标 |
color |
主题色(用于标题、边框等) |
bgColor |
卡片背景色 |
pillBg / pillText |
标签胶囊的背景色和文字色 |
加一个新领域,要动三处:
- 在
src/config/domains.ts中添加领域配置。 - 在
src/content.config.ts的 domain 枚举中添加新 slug。 - 在
.claude/skills/ai-auto-push/SKILL.md中添加对应的抓取规则。
改完运行 /ai-auto-push,新领域的日报就会跟着生成。
2026 年 10 月补记
以上是当时的完整做法。下面这段,是今天回头补上的。
AI Auto Push 上线后实际运行过一段时间,后来被我关停了,仓库和在线预览也已经下线。前面那些设计,单看每一条都说得通,放进每天的运行里,问题才慢慢露出来。
为什么关掉它
第一,技能执行不够稳定。 只收当天、每个领域 3 到 5 条、保留双链接、没内容就生成空文件,这些规则都写在 SKILL.md 里,标准模板也定好了。可技能终究是一份写给模型的说明,照不照做,由执行它的模型决定。大多数时候它照着走,偶尔就会偏出去一步。一个每天都要跑的系统,偶尔偏一步,就等于隔一阵子要人去看一眼,这和「零人工干预」的初衷正好拧着。
第二,抓回来的内容重复。 信源之间本来就有交叉,36氪 一家就出现在三个领域里;一条大新闻发出来,好几个站都会转。去重只发生在一次运行里,靠模型自己比对,抓回来的内容一多,重复的条目还是会混进日报。
第三,选不出真正的精选。 「每个领域留 3 到 5 条」限得住数量,限不住质量。某天值得看的只有一条,也会凑出几条;某天重要的消息很多,也只能挑五条。我想要的是「值得看才出现」,实际做到的只是「最多出现几条」。
第四,信源不稳定。 网页改版、访问失败、搜索结果飘忽,都会让某个领域当天抓不到东西,或者抓到的不对。流程能做的只有用搜索补一补,再不行就生成空文件。哪个信源最近总出问题、该换还是该修、漏掉的内容能不能补回来,整套流程里既没有地方记,也没有地方处理。
第五,Token 费用太高。 每天 4 个子 Agent 各自读网页、搜结果、比对、写摘要,读进去的每一段网页内容都要算 Token。资讯天天有,这笔钱也天天花,模型费用一路算下来,实在太高。
五个问题叠在一起,我把网站关了。
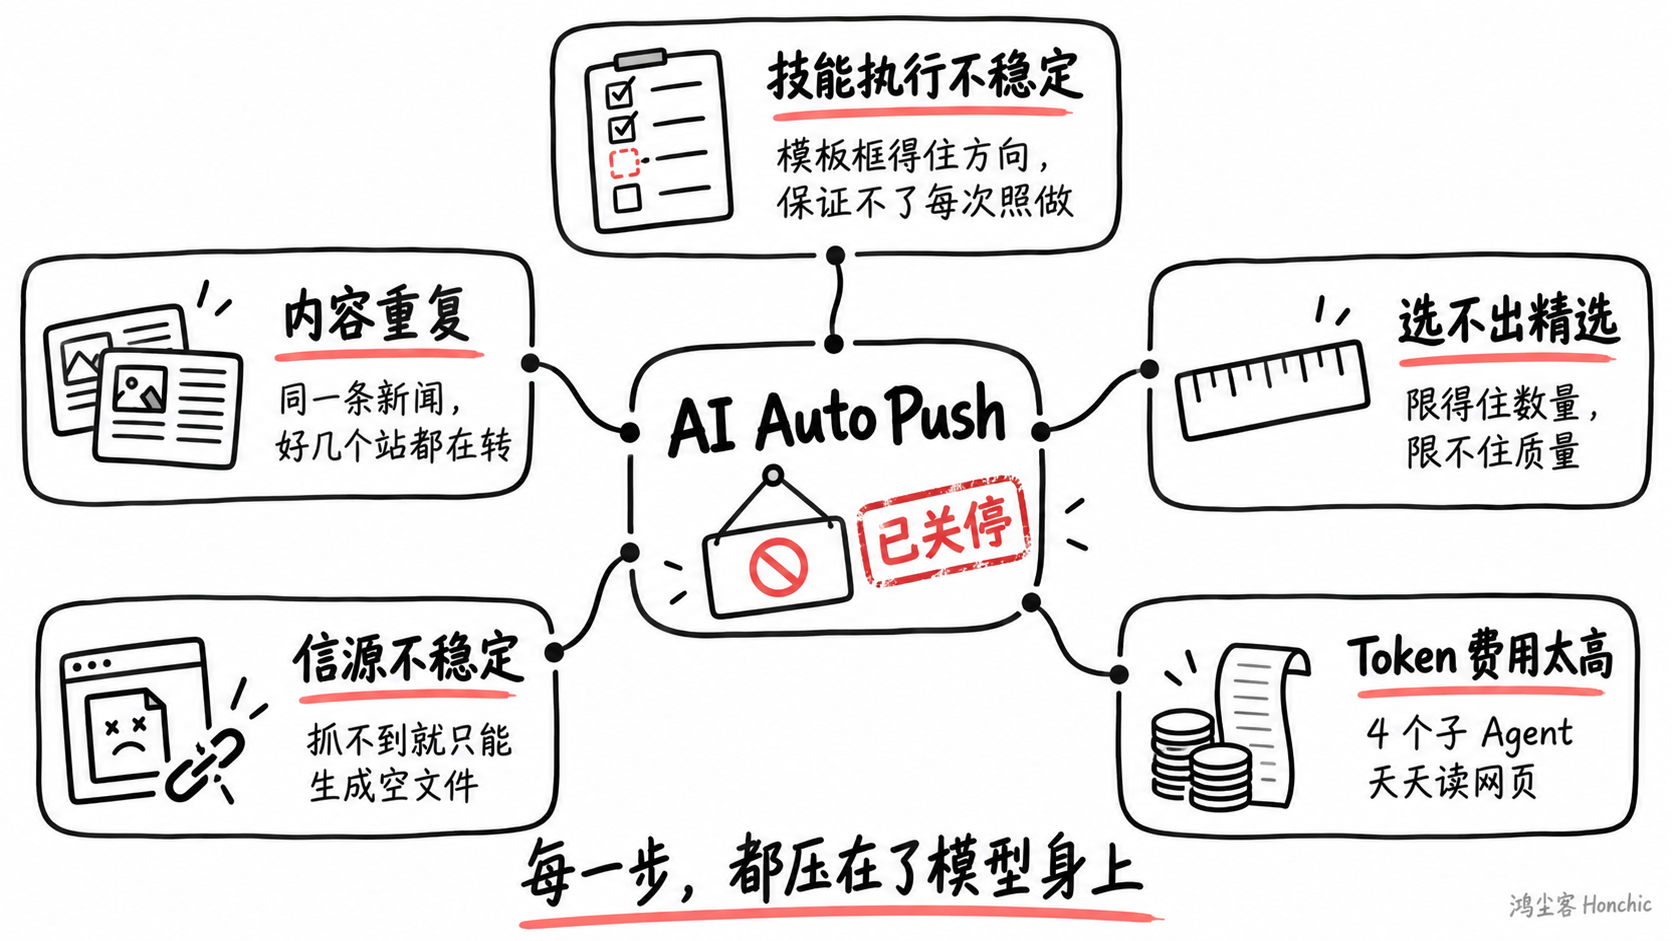
现在回头看,问题不在某一句提示词写得不够好。抓取、去重、筛选、记录失败、控制花销,几乎每一步都压在了模型身上。每天一模一样、一步不差地重复同一件事,恰恰是代码比模型更擅长的活。
龙虾退潮以后
我的小站关了,开头那只刷屏的龙虾,后来热闹得比我想的还要夸张。
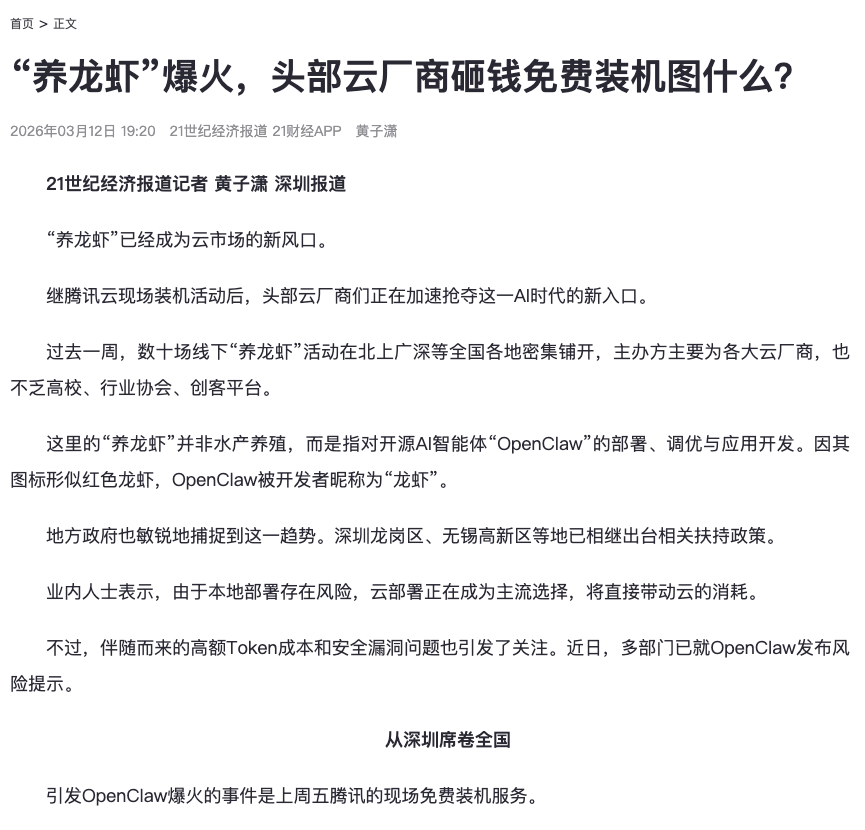
3 月 6 日,近千名开发者和 AI 爱好者来到深圳腾讯大厦,在腾讯云工程师的协助下完成了 OpenClaw 的云端安装。这是 21 世纪经济报道记下的一幕。那段时间,几乎每家厂商都端出了自己的虾。腾讯有 WorkBuddy 和内测中的 QClaw,字节在火山引擎上线了云端 SaaS 版的 ArkClaw,阿里有 CoPaw,百度办了免费安装活动,又在北京开了一场「龙虾市集」,京东云、小米、360 也各自跟进。上门安装一次,报价能到 500 元到上千元。
一时间,好像不养一只虾,就要被这一轮 AI 落下。
热得快,凉得也快。3 月 11 日,《商学院》杂志的报道标题已经是「第一批养虾人已经开始卸载了」,代卸载服务报价从 29.9 元到 299 元。到了 5 月,投中网一篇采访写道,OpenClaw 的微信搜索热度已经跌到高峰期的 3% 左右。
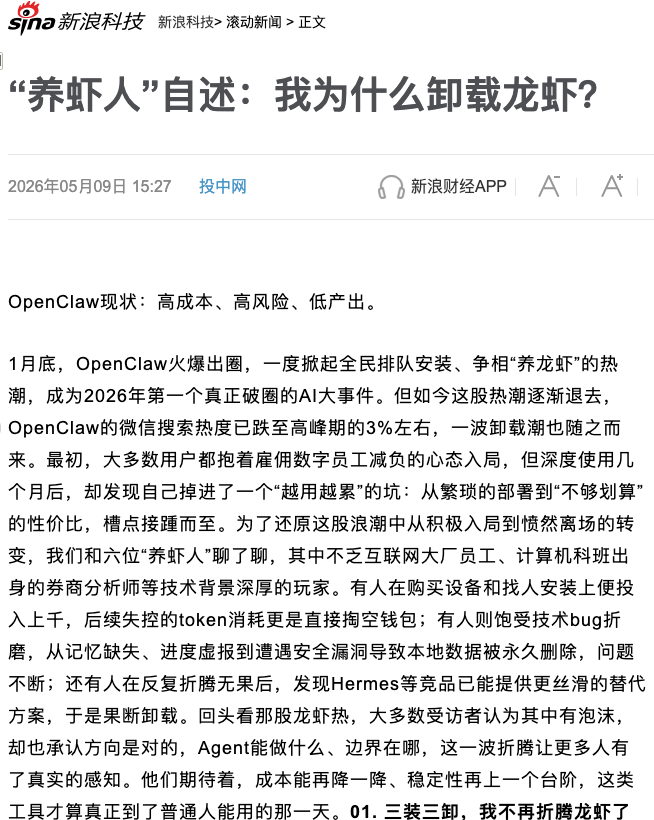
受访的养虾人说得很直白。有人说「本来20分钟做完的事,用龙虾反而要折腾半小时去核实和纠错」,有人说「大家逐渐意识到并不是每个人都需要它」。同一篇文章也没把话说死,多数受访者认为这股热潮里有泡沫,也承认方向是对的,这一波折腾让更多人对 Agent 能做什么、边界在哪,有了真实的感知。
浪潮过去,据我观察,真正留下来天天用的人寥寥无几。
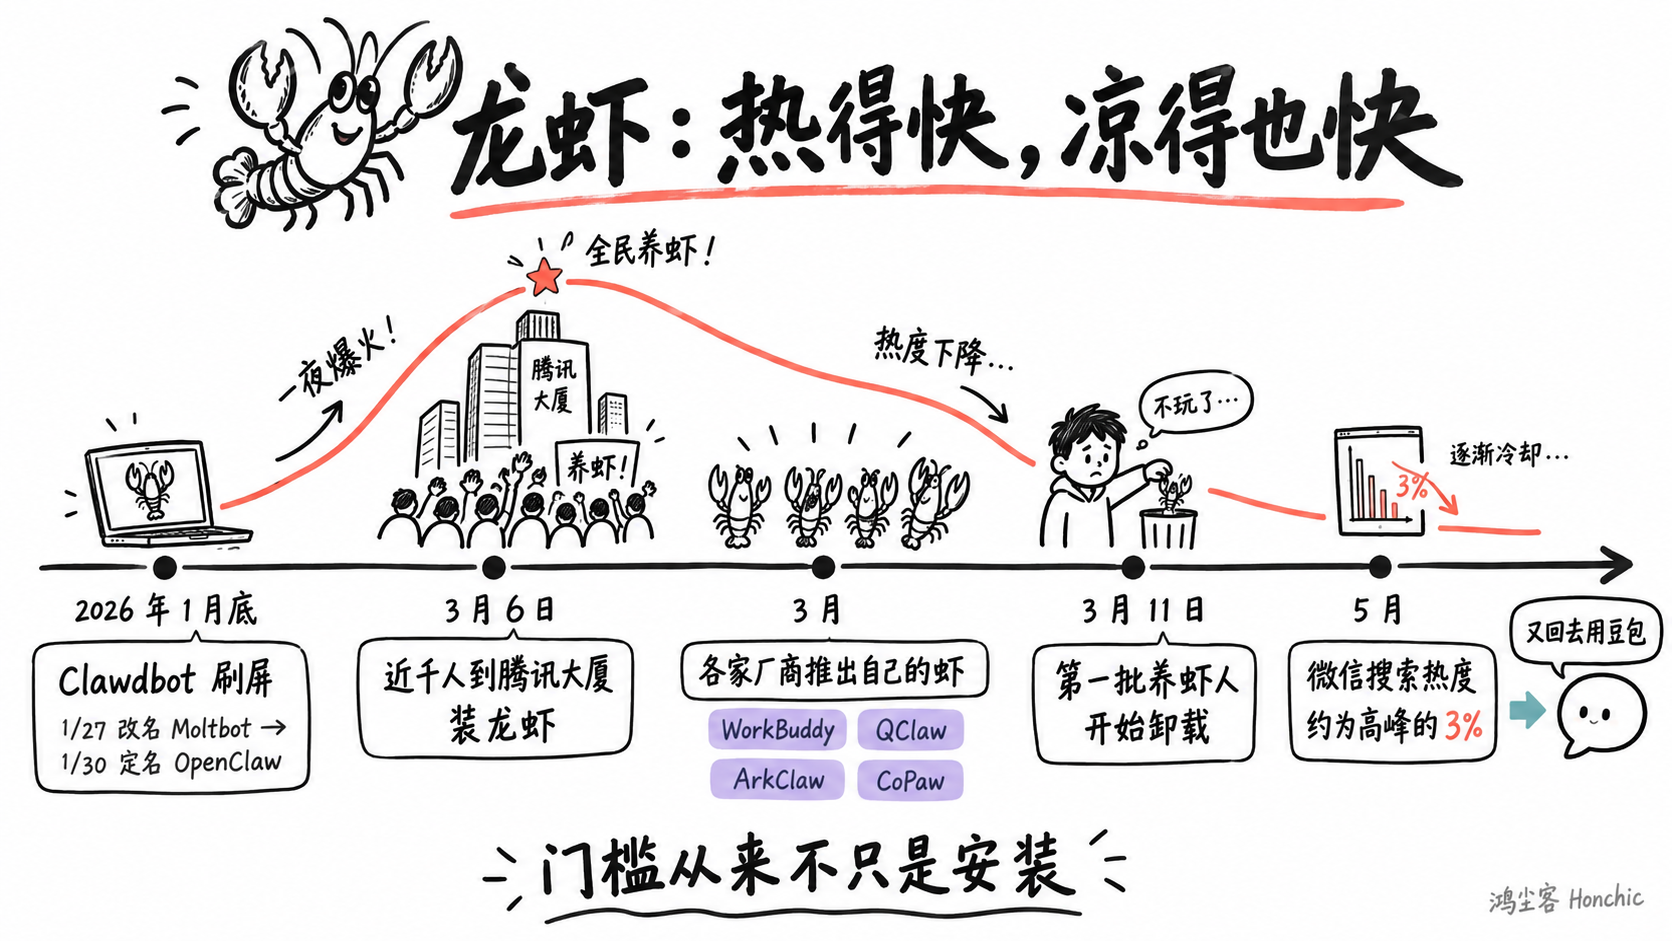
更有意思的是这些人后来去了哪儿。当初追着养虾的人,不少又回去用豆包了。
豆包不用部署,不用配渠道,也不用操心 Token 账单,打开就能问,问完就有答案。从龙虾绕一圈回到豆包,又回到了「有问题,就问 AI」这一步。
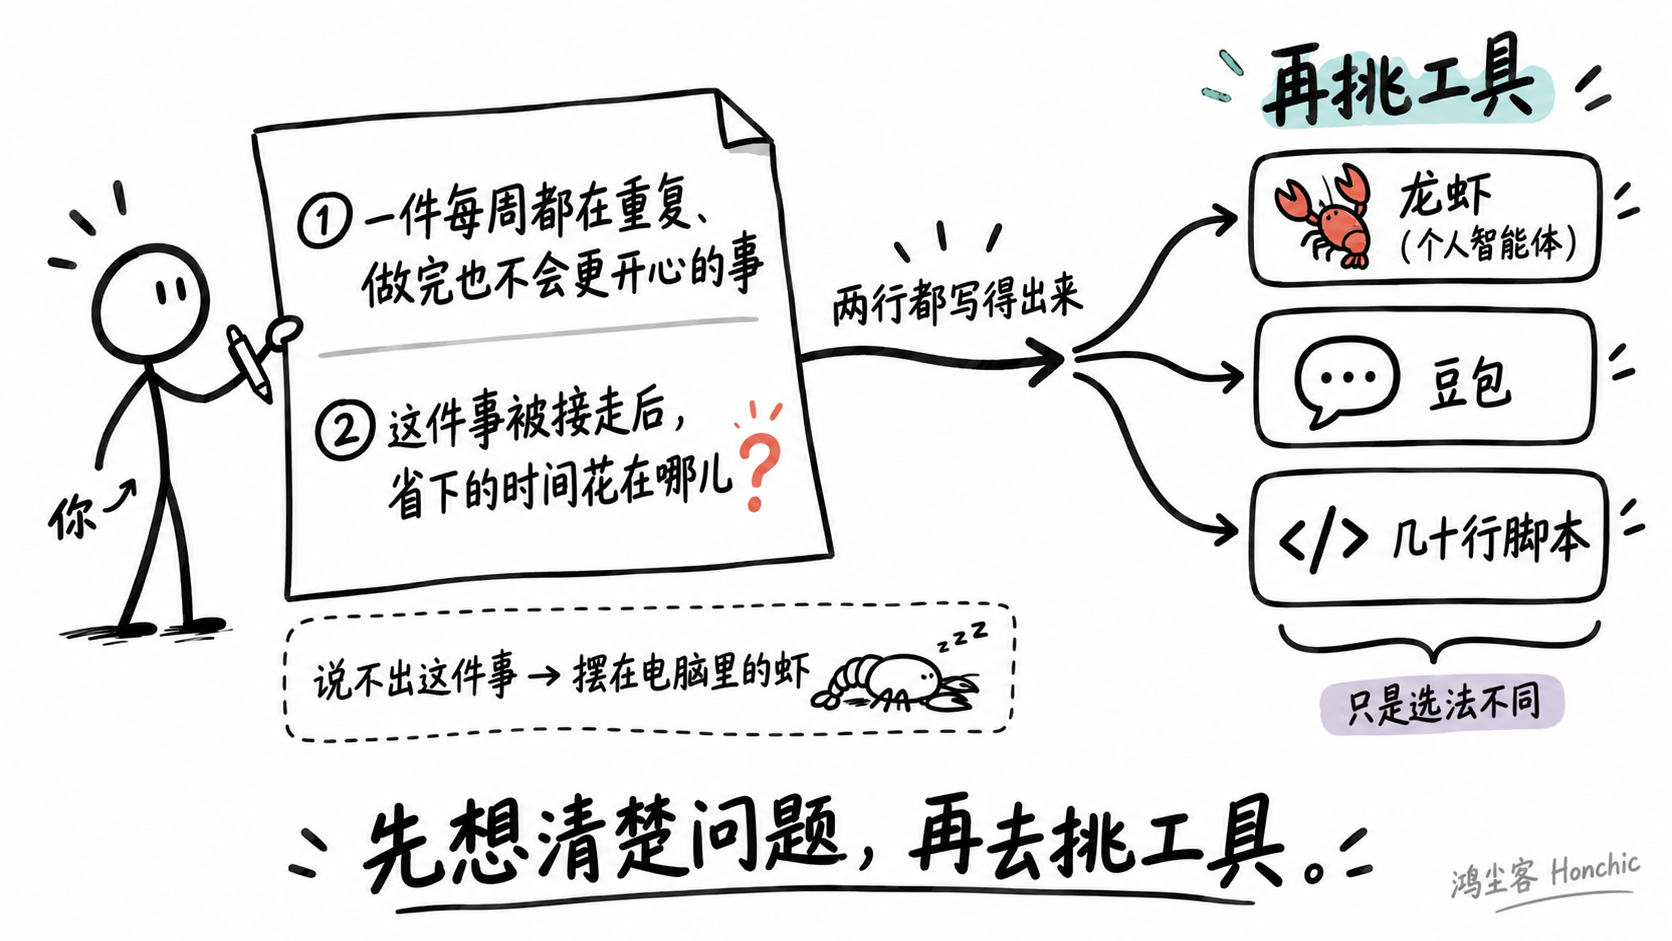
龙虾的门槛,从来不只是安装。 真正难的是装好以后,第一句话该对它说什么。
个人智能体能定时,能联网,能读写文件,能替你发消息。可它要接住的,得是你身上一件具体、重复、说得清楚的事。说不出这件事,它就只是一只摆在电脑里的虾,偶尔被叫起来聊几句天。聊天这件事,豆包做得更省心。
所以在我看来,很多人卡住的地方不在不会装,而在没想清楚要用 AI 提什么效率。再往下问一层,就算效率真的提上来了,省下来的时间又打算拿去做什么?这个问题没有答案,「提效」就只剩一个好听的说法。热闹过去,工具自然就闲下来了。
我算是运气好的那一类。AI Auto Push 从第一天起就有一件明确的事,每天替我看资讯。可就算问题这么清楚,它还是倒在了稳定性、重复内容和 Token 账单上。把问题说清楚只是第一步,接下来还得把流程交给更可靠的东西。
对个人智能体,我现在的想法是先别急着养虾。拿出一张纸,写下一件你每周都在重复、做完也不会更开心的事,再写下这件事被接走以后,你想把省下来的时间花在哪儿。两行都写得出来,再去挑工具。到那时候,用龙虾、用豆包,还是写几十行脚本,都只是选法不同。
后来换了一条路
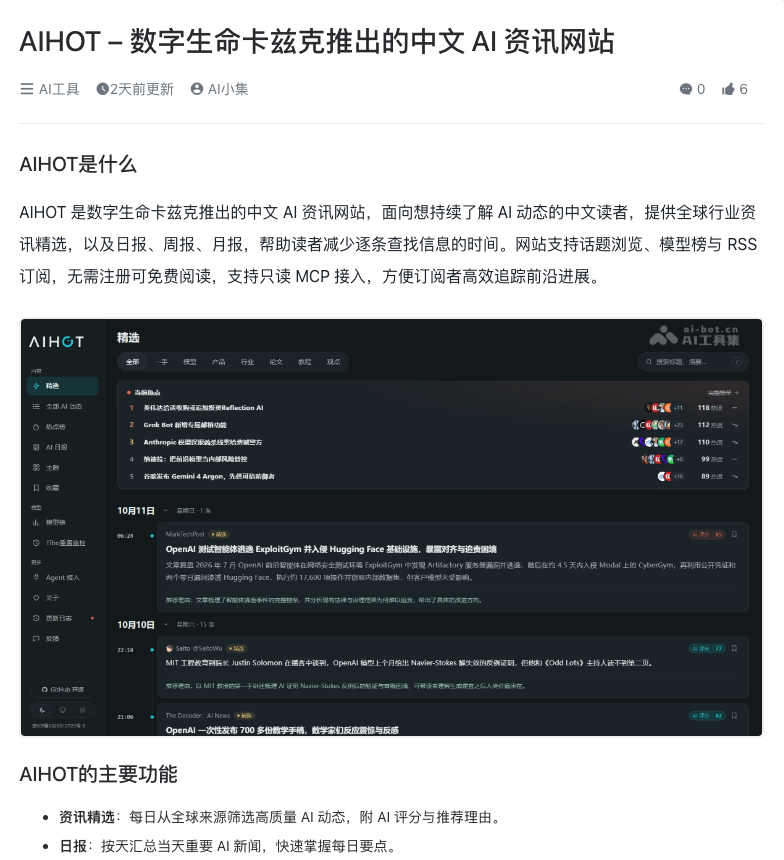
关站以后,我刷到了 AIHOT。它由「数字生命卡兹克」开发,2026 年 4 月上线,把分散的 AI 资讯整理成精选、热点和日报。之后我一直关注着它。
有个巧合挺有意思。AI 工具集 ai-bot.cn,也就是当年 AI Auto Push 在 AI 技术领域的信源之一,后来也收录了 AIHOT,介绍它是数字生命卡兹克推出的中文 AI 资讯网站,提供全球行业资讯精选,以及日报、周报、月报。
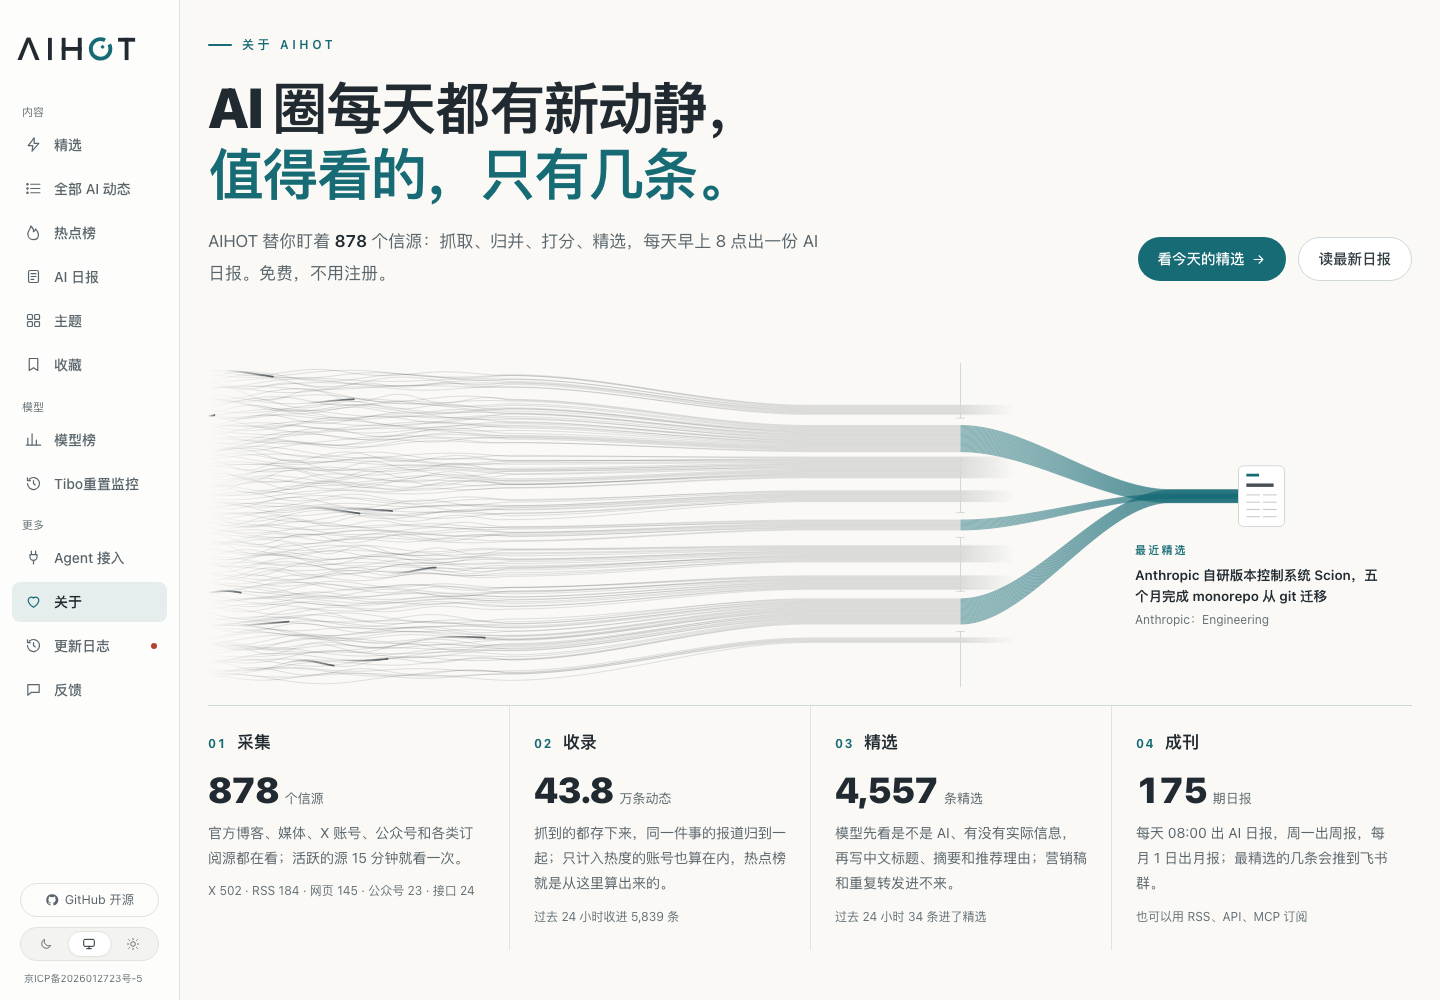
AIHOT 自己的关于页,第一句话写着:「AI 圈每天都有新动静,值得看的,只有几条。」我当年第三个问题想要、却没做到的「值得看才出现」,就是这句话。
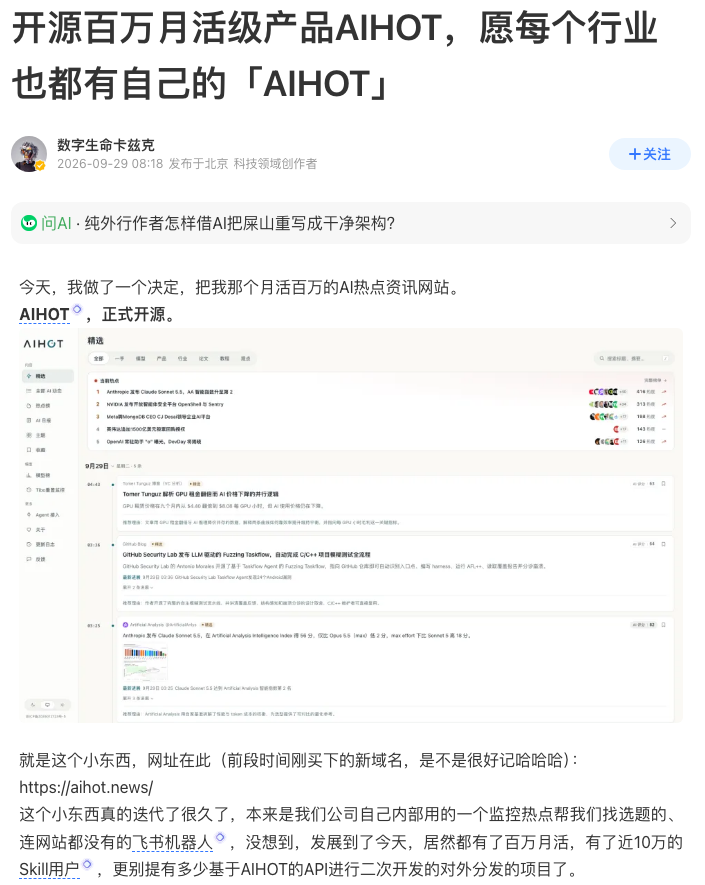
2026 年 9 月 29 日,卡兹克发文宣布开源 AIHOT,标题是《开源百万月活级产品AIHOT,愿每个行业也都有自己的「AIHOT」》。按他文中的说法,这个网站起初是他们公司内部用来监控热点、帮忙找选题的工具,后来发展到了百万月活。至于为什么开源,他写的是「既然我没有办法满足所有人,那不如就把火种交到大家自己的手上」。
开源的范围,文中也说得很清楚。采集流程、精选评分流程、聚簇机制,以及生产环境里用到的 Prompt 都放出来了;具体信源因为这类网站的特殊性,没有公开。代码以 MIT 许可发布在 GitHub 上,仓库是一个公开模板,把信源和精选标准换成自己的,就能搭一个行业热点站。
我在这套框架上搭了 EmbHot,做的是嵌入式与具身智能这个行业的版本,地址是 embhot.zhcmqtt.top。
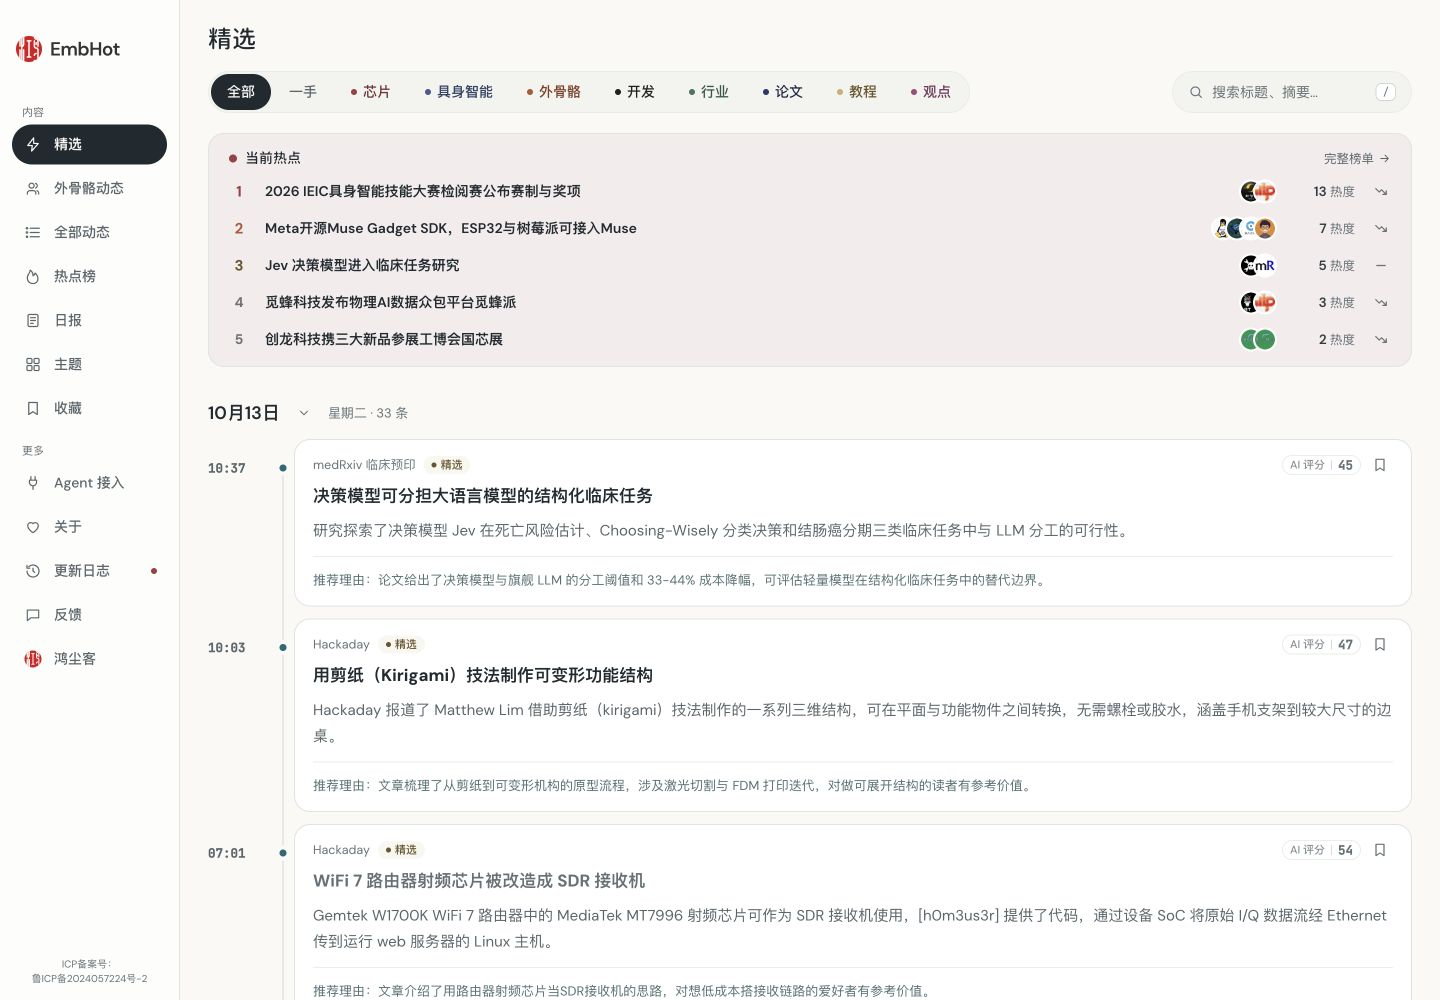
先把分工说清楚。采集、精选、事件归组、热度、成刊和后台这些能力,来自 AIHOT 的开源引擎,不是我写的。我做的是这个行业自己的部分:信源名单、分类和公司名录、主题、提示词和入选门槛。信源没有随框架开源,EmbHot 首次启动导入的 95 个信源是按这个行业重新整理的,覆盖芯片原厂的 SDK 发布、官网新闻、嵌入式社区公众号和每日论文。
拿当年那五个问题去对照,能看到它们在这套框架里各自有了去处:
| 当年的问题 | AI Auto Push 的做法 | EmbHot 的做法 |
|---|---|---|
| 执行不稳定 | 一份技能说明,由模型从头跑到尾 | 抓信源、调模型、归组、算热度、出刊拆成后台任务和定时任务,模型只负责评分、写作和归组判断 |
| 内容重复 | 一次运行内由模型比对 | 先判重,再在最近两周里找候选,把不同来源说的同一件事聚成一个事件,后续进展挂在下面 |
| 无法精选 | 每个领域固定留 3 到 5 条 | 同一份标准独立打两次分,按信源分级设门槛,过线才进精选 |
| 信源不稳定 | 抓不到就生成空文件 | 后台能看每个信源的失败原因;抓取失败不推进位置,下次从同一处继续,连续失败的信源会标红 |
| Token 费用高 | 每次运行都让模型读全部网页 | 每一步可以单独换模型;付费请求先记回执,重试时复用已付费的结果;按分钟、小时、天设上限,超过就暂停 |
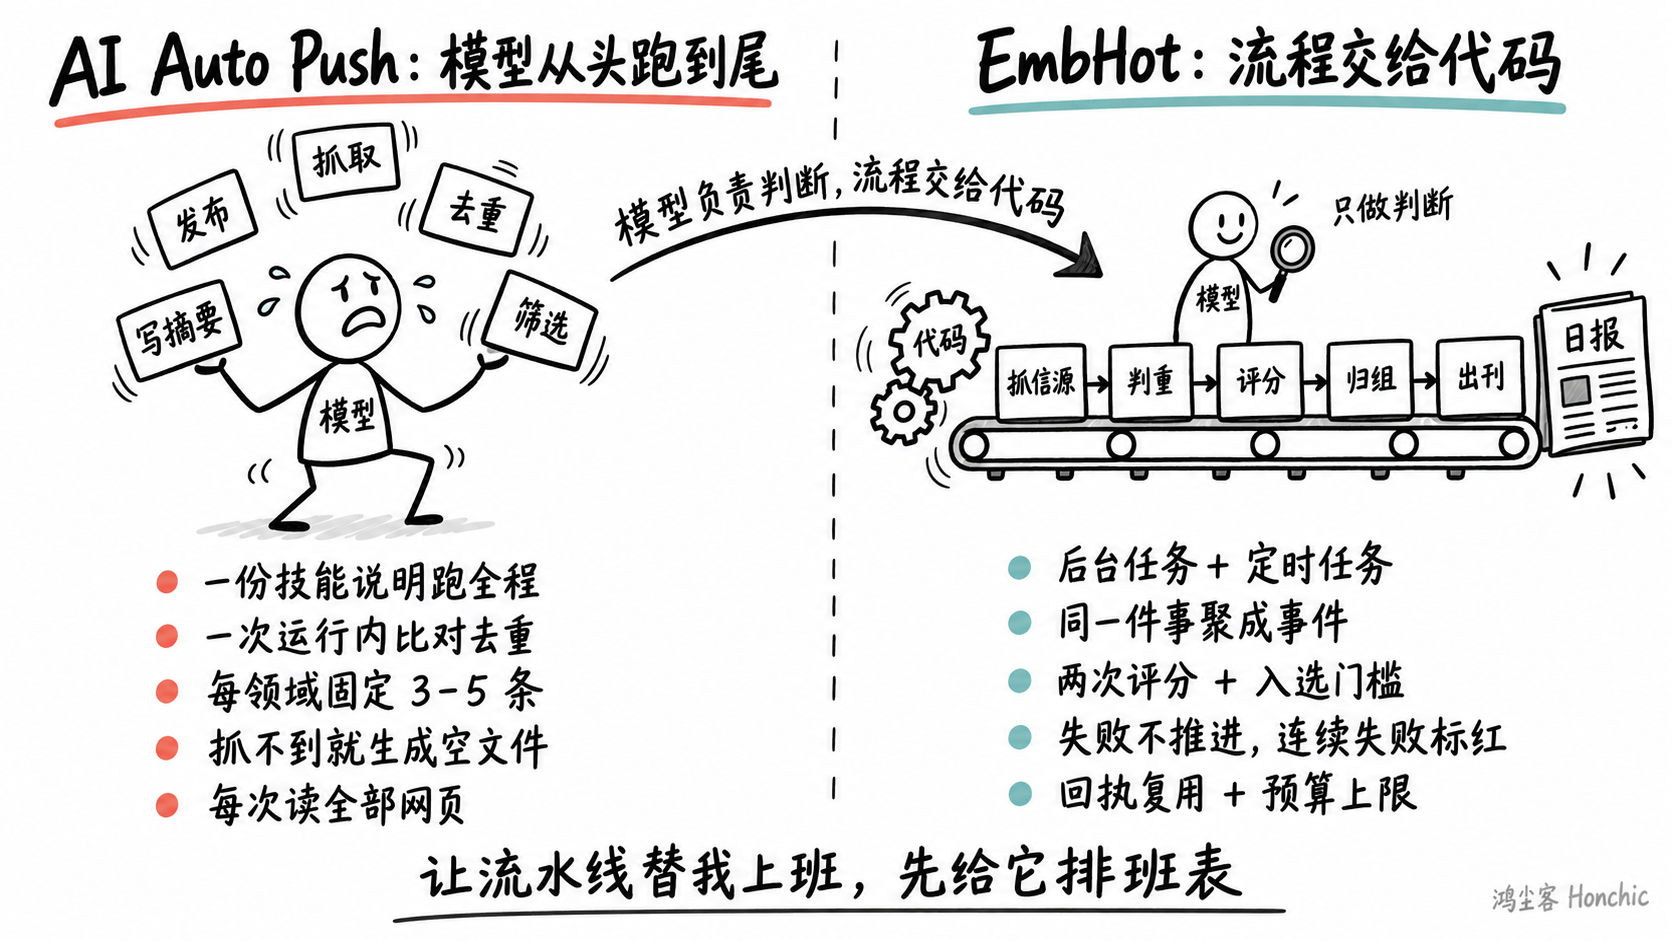
几处细节,正好对着当年最头疼的地方。
精选不再按条数卡,改按分数卡。两次评分取平均,官方一手的门槛是 56,官方账号与准官方是 58,媒体与个人是 60。一件事被 10 家以上不同信源报道时,相关报道自动进入精选,共识本身就是信号。
重复也换了思路。不再追求把重复的报道删干净,而是把它们聚到一起。官网发一篇、媒体转十篇,读者只需要看到一次;热度也按事件算,同一个来源发十篇只算一次。
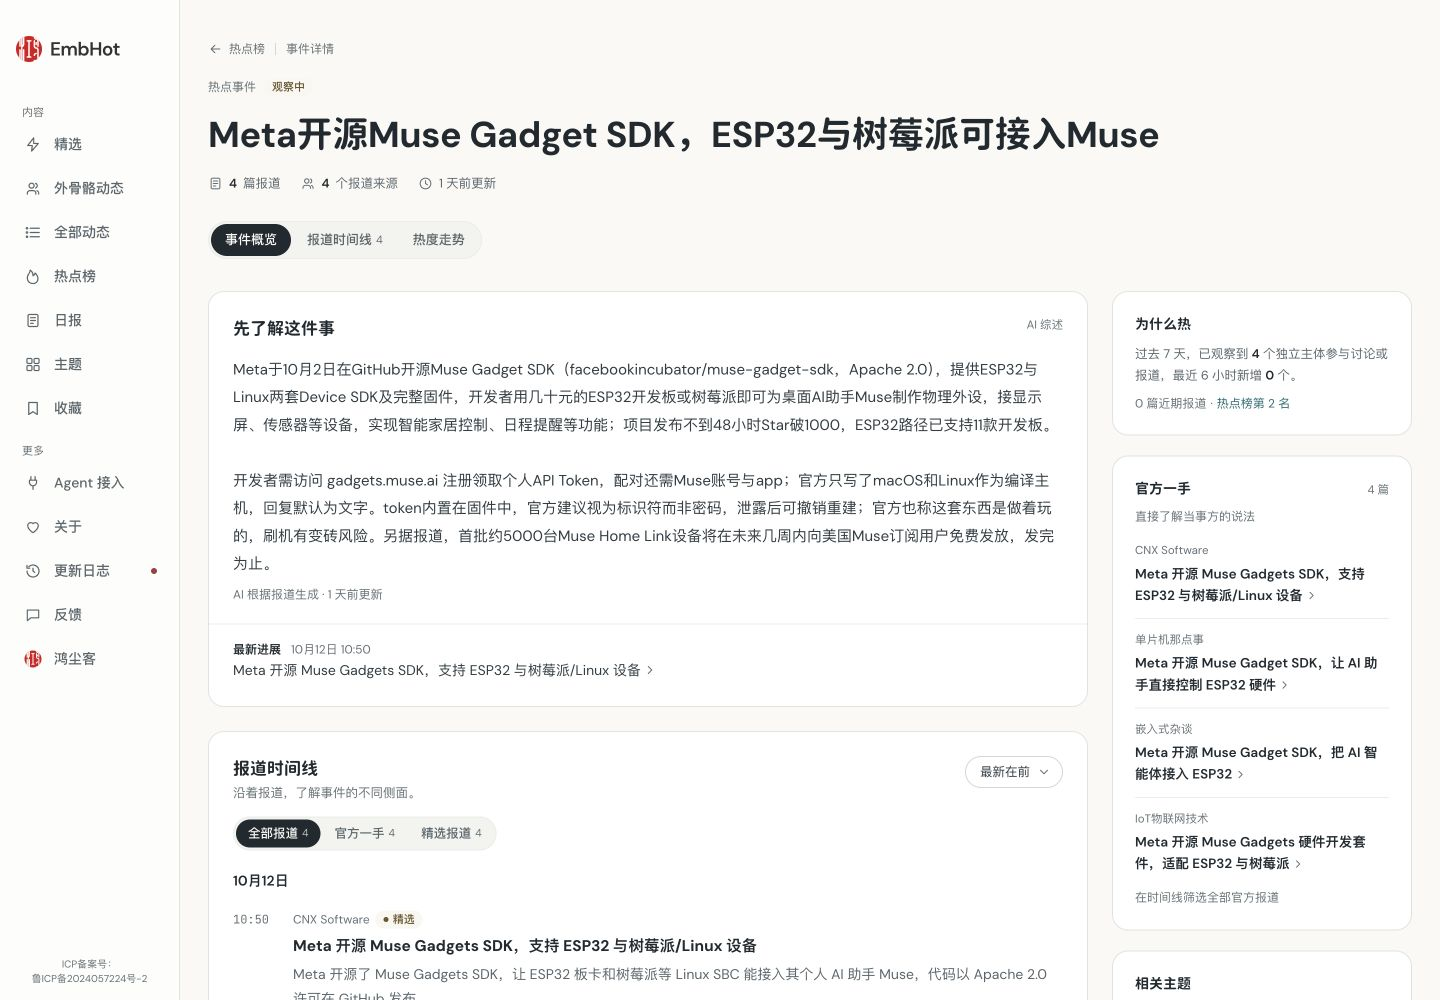
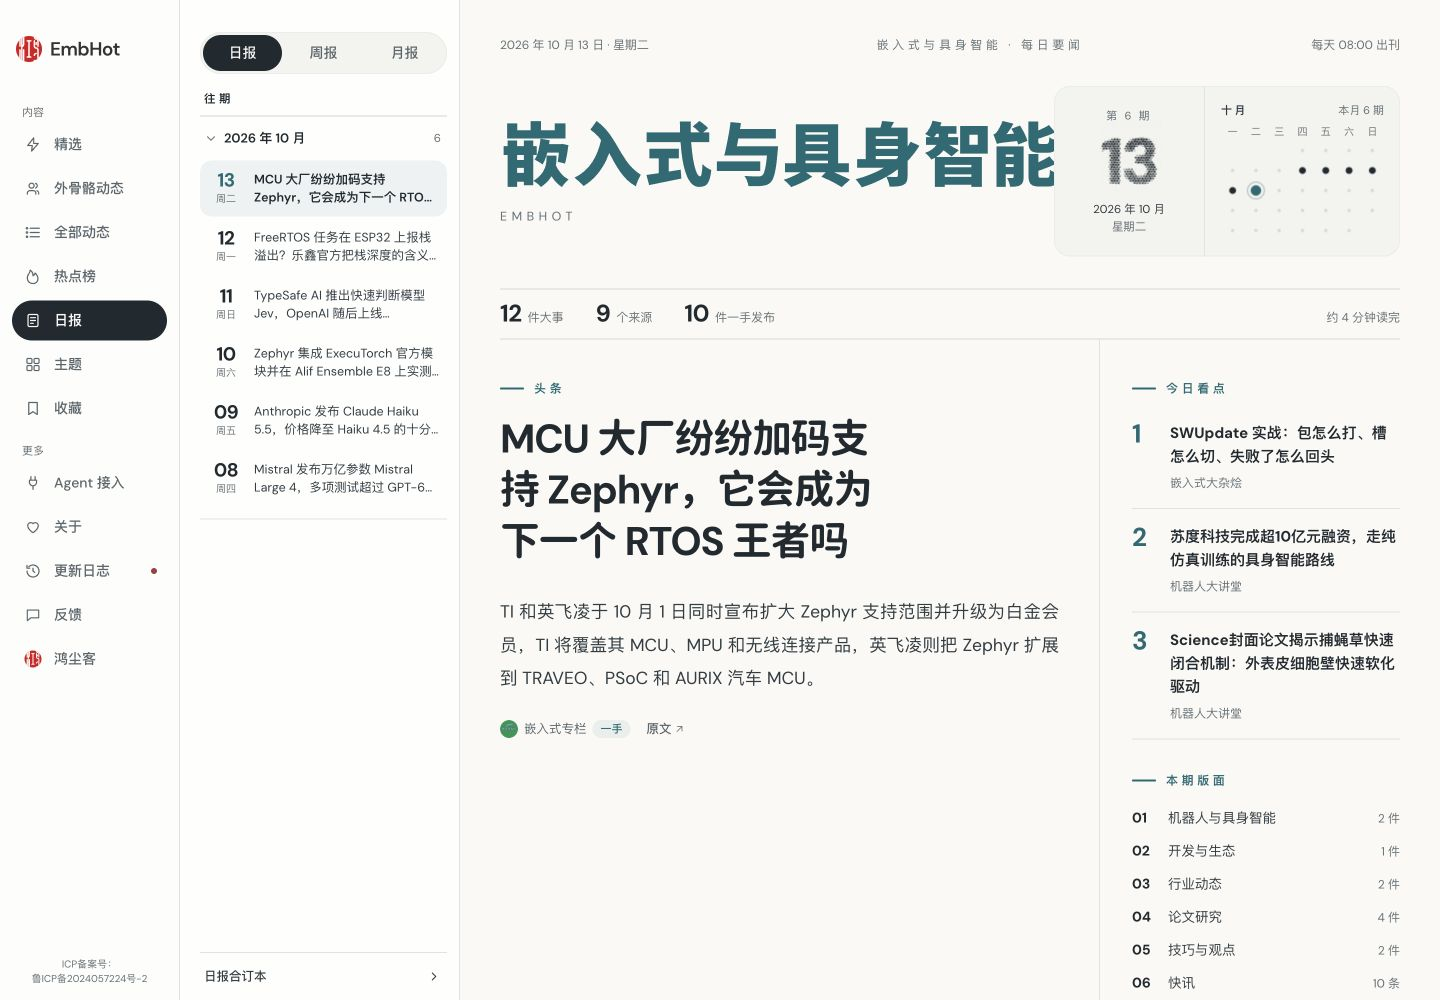
出刊有了兜底。日报按规则编排,不调用模型。系统每半小时检查一次,到点的刊期出一次,已经出过的不重写;停机错过的、失败的,会在之后的检查里补上。归组时模型调用失败或者回答不合格式,这条资料就停在原处,等待超过 10 分钟会告警,不会带着错误往下走。
当然,它也不是万能的。筛选可能漏掉你关心的消息,事件归组和 AI 摘要也可能出现偏差,模型调用照样要花钱。区别在于,这些问题现在有地方记录、有地方告警、有地方设上限,出了问题能找到是哪一步。做选型或技术判断时,还是要回原文核对。
模型负责判断,流程交给代码。 这是 AI Auto Push 关掉以后,我最想记下来的一句话。
巧的是,EmbHot 的日报也在北京时间早上 8 点出刊。还是那个时间,只是这一回,排班表背后多了考勤记录和报销上限。
参考资料
至顶科技:AI助手OpenClaw五天内三次更名的疯狂历程(腾讯新闻,2026-02-02)
飞书官网:一文完全搞懂OpenClaw(Clawdbot)附飞书对接教程(2026-02-03)
OpenClaw 文档:Automation payloads(会话执行方式)
OpenClaw 文档:Automation delivery(announce 投递)
21世纪经济报道:“养龙虾”爆火,头部云厂商砸钱免费装机图什么?(2026-03-12)
《商学院》杂志:第一批“养虾人”已经开始卸载了(澎湃新闻,2026-03-11)
投中网:“养虾人”自述:我为什么卸载龙虾?(新浪科技,2026-05-09)
ai-bot.cn:AIHOT – 数字生命卡兹克推出的中文 AI 资讯网站
鸿尘客 Honchic · 把脑洞焊到电路板上