在飞书给 OpenClaw 机器人发一句「小红书流程」加文章链接,Claude CLI 就按顺序完成原文抓取、标题评分、两篇正文仿写、文档落盘和火山引擎配图,最后把两篇图文稿和 8 张黑板报配图存进本地文件夹,再回传飞书通知。本文拆解五个技能的分工、子代理之间的数据交接,以及纯文本校验、目录防撞和可视化终端这些工程细节,并附一次真实运行的完整产出。文末补记小红书此后对 AI 托管账号的治理,以及为什么现阶段 AI 还不能全自动接管自媒体运营。
在飞书里给机器人发一句话:
小红书流程 https://m.ithome.com/html/927729.htm然后就不用管了。过一会儿,飞书弹回一条执行结果。本地文件夹里多出一个新目录,两篇小红书正文、两条能直接粘贴的发布简版、8 张黑板报风格的配图,都已经躺在里面。
这是我搭的一条内容流水线。入口是 OpenClaw,干活的是 Claude CLI 和它身上挂的 5 个技能。
这篇从头拆一遍,讲它们怎么分工、怎么交接,以及中间踩过的几个坑。
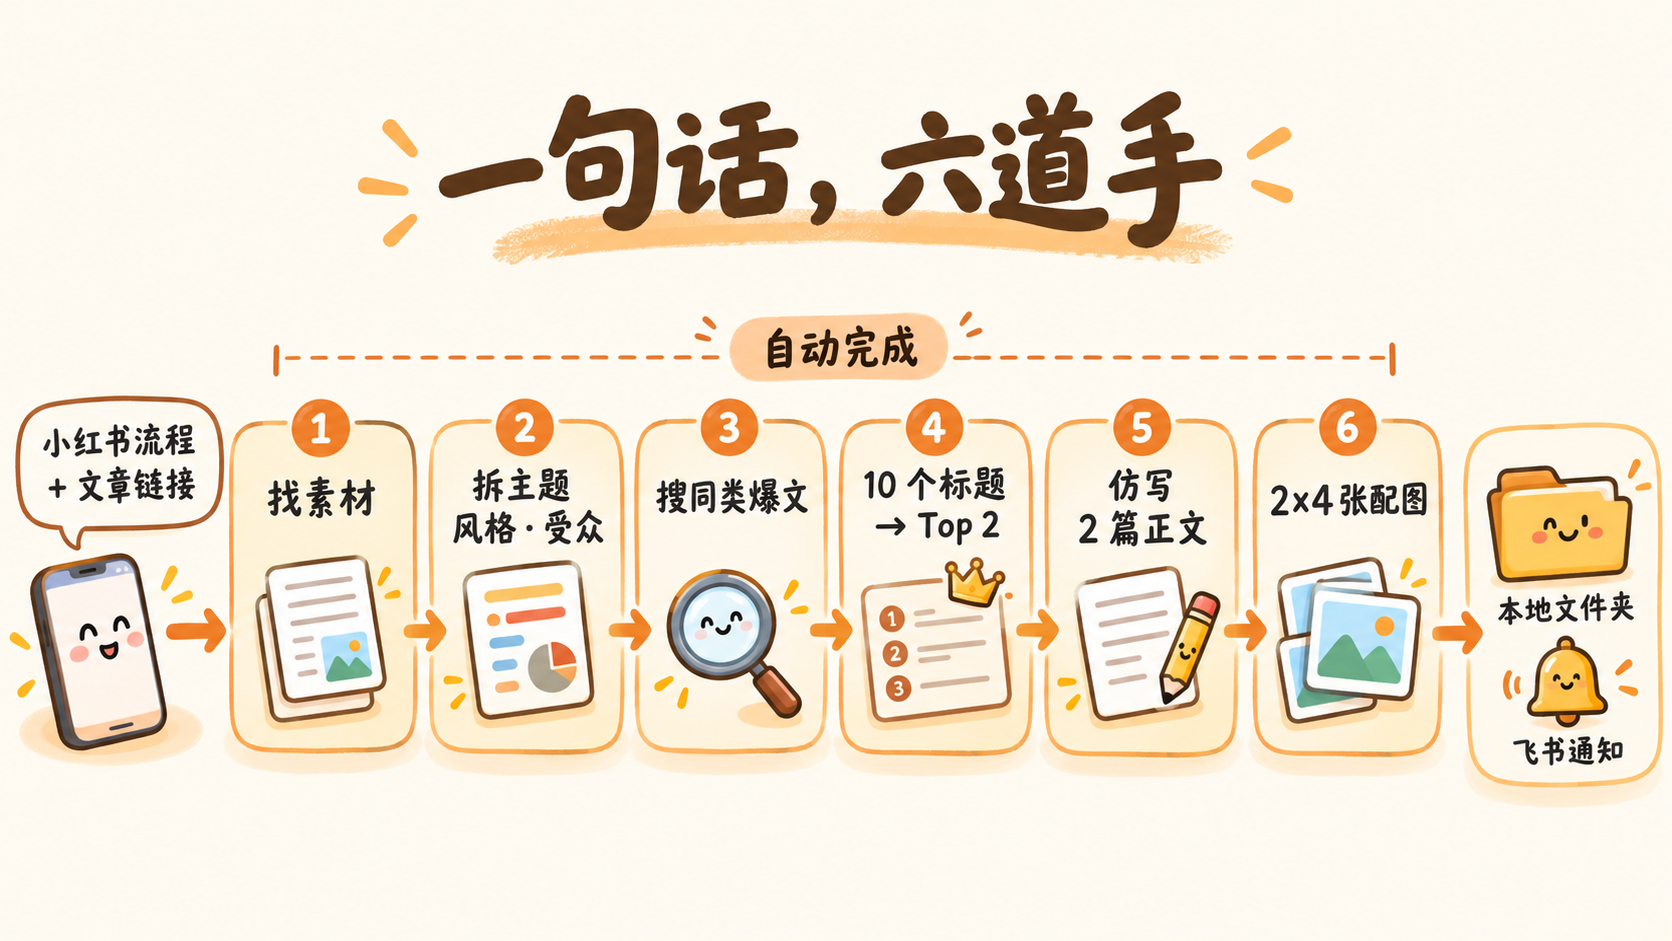
一篇笔记,要过六道手
做过小红书运营的人大概都熟悉这套流程。一篇能火的笔记,背后通常要走这几步:
- 找到一篇热点素材文章。
- 分析它的主题、风格和受众。
- 搜几篇同类爆文作参考。
- 写出多个标题候选,筛出最有爆款潜力的。
- 仿写两篇不同角度的正文。
- 配上风格统一的系列图片。
每一步都要花时间,也要经验。
我想要的效果很简单。在飞书给机器人发一条消息,十分钟后收到通知,所有产出物自动存进本地文件夹,打开就能复制发布。
六道手,最好一道都不用我亲自动。让流水线替我上班,前提是每一道手都有人接。
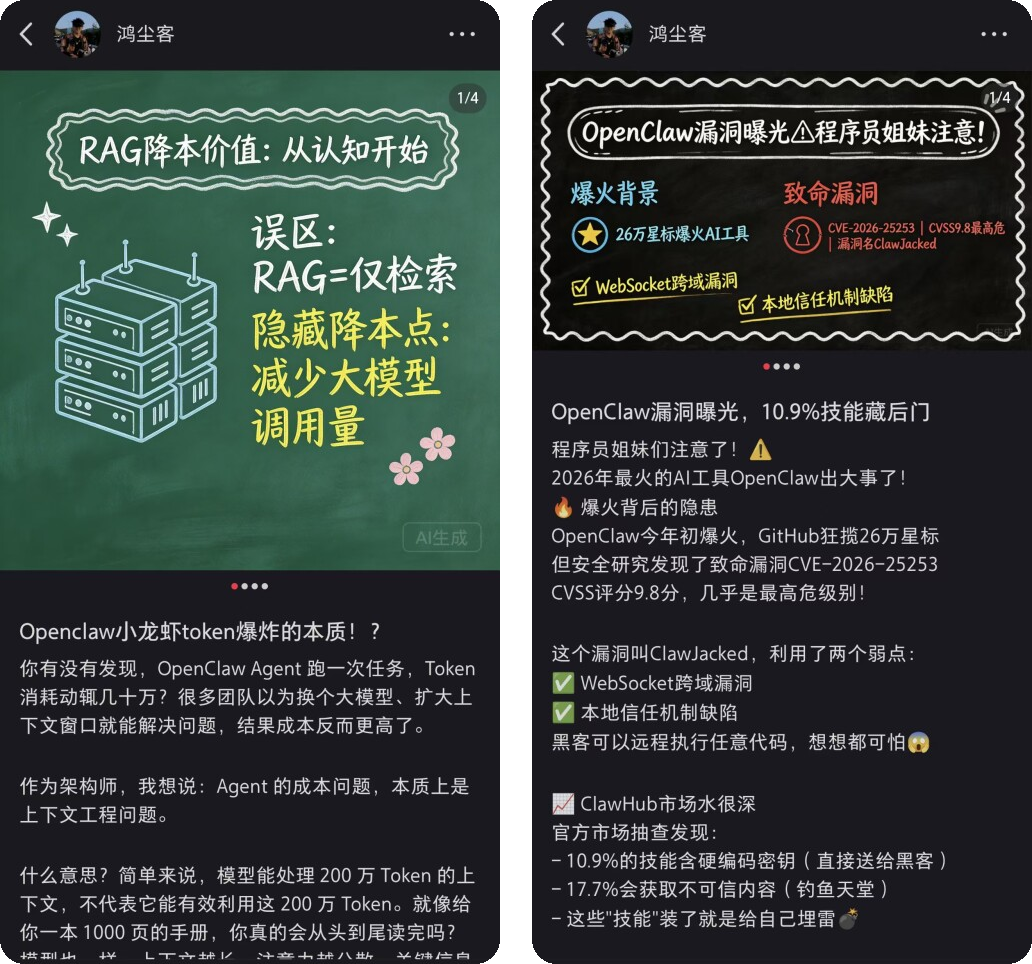
先看成品。下面是用这条流水线做出来、发到小红书上的两篇笔记。
五个技能,串成一条线
整套系统由 5 个独立技能组成,靠子代理机制串起来:
飞书消息触发
    │
    ▼
┌─────────────────────────────────┐
│  技能1: xiaohongshu-auto-process│  ← OpenClaw 监听飞书消息
│  (入口调度层)                    │     提取链接 → 启动 iTerm + tmux
│                                 │     → 启动 Claude CLI
└──────────┬──────────────────────┘
           │ 发送 /auto-xiaohongshu 命令
           ▼
┌─────────────────────────────────┐
│  技能2: auto-xiaohongshu        │  ← Claude 主流程编排器
│  (流程总控层)                    │
│                                 │
│  步骤1: 抓取原文 + 分析主题      │
│  步骤2: 联网检索同风格参考文章    │
│         │                       │
│         ▼                       │
│  ┌─── 步骤3: 子代理 ──────┐     │
│  │  技能3: fire-title      │     │
│  │  生成10个候选标题        │     │
│  │  评分筛选 Top 2          │     │
│  └──────┬──────────────────┘     │
│         │ selected_titles        │
│         ▼                       │
│  ┌─── 步骤4: 子代理 ──────┐     │
│  │  技能4: fire-content    │     │
│  │  仿写2篇完整正文        │     │
│  │  + 2条发布简版摘要       │     │
│  └──────┬──────────────────┘     │
│         │ 2篇正文 + 2条摘要      │
│         ▼                       │
│  ┌─── 步骤5: 子代理 ──────┐     │
│  │  文档落盘                │     │
│  │  报告版.md + 发布版.md   │     │
│  └──────┬──────────────────┘     │
│         │ 文件路径                │
│         ▼                       │
│  ┌─── 步骤6: 子代理 ──────┐     │
│  │  技能5: picture          │     │
│  │  调用火山引擎生图API      │     │
│  │  2×4张配图 → 回写文档    │     │
│  └──────────────────────────┘     │
└──────────┬──────────────────────┘
           │
           ▼
飞书通知执行结果步骤之间传的是结构化数据,不是一段随意的聊天记录。每个子代理跑完都要过强校验,不通过就自动重试一次,再不行就终止。
宁可停下来报错,也不把半成品往下游传。
接下来按顺序,一个一个看。
入口:OpenClaw 盯着飞书
技能 1 叫 xiaohongshu-auto-process,部署在 OpenClaw 上,专门盯飞书消息。
它的触发条件很朴素,消息里同时出现关键词「小红书流程」和一个 HTTP 链接。实际的 skill.js 用正则 /小红书流程.*https?:\/\//i 做匹配。
命中以后,它做的事情是这样一串:
用户飞书消息 → 提取链接 → tmux 创建会话 → iTerm 打开可视化终端
→ 启动 Claude CLI → 发送 /auto-xiaohongshu 命令 → 轮询等待完成
→ 捕获结果 → 飞书回传通知
这一层有三处设计。
- 用 tmux + iTerm 跑,整个过程是看得见的,随时能切到终端看实时进度。
- 怎么知道 Claude 干完了?轮询检测 Claude CLI 的输入提示符
❯。提示符重新出现,就说明它停下来等人了。最长等 10 分钟。 - 结束后自动抓终端输出的最后 200 行,作为日志摘要推回飞书。
整个流程异步执行,不会卡住飞书那边的消息响应。
总控:auto-xiaohongshu 在调度
技能 2 是真正的大脑。它跑在 Claude CLI 里,是一个自定义斜杠命令,负责把后面所有步骤排好队。
抓原文,准备了六条退路
原文抓取是整条流程里最容易翻车的一环。很多内容站,尤其是微信公众号和小红书站内文章,对爬虫有各种限制,单靠一种方法成功率不高。
所以我给它设计了 6 种方法,一层失败就降到下一层:
Web_Fetch → Chrome 浏览器渲染 → curl 源码下载
→ Brave Search 搜镜像 → Web Search 搜同主题 → agent-reach 平台专用通道
6 种全部失败才终止,每一次失败都记下具体原因。
步骤 3 到 6,必须交给子代理
从步骤 3 开始,总控强制通过 Agent 工具启动独立子代理执行。这样做有两个考虑。
- 上下文隔离。每个子代理只拿到本步骤需要的输入,不会被上游的无关信息带偏。
- 失败隔离。某一步出错,不会弄脏其他步骤的执行环境,重试时也是干净的。
子代理之间的数据交接是这样的:
步骤1产出 source_summary ──→ 步骤3 + 步骤4
步骤2产出 reference_articles ──→ 步骤3 + 步骤4
步骤3产出 selected_titles ──→ 步骤4 + 步骤5
步骤4产出 2篇正文 + 2条摘要 ──→ 步骤5 + 步骤6
步骤5产出 文件路径 ──→ 步骤6
每一步吃什么、吐什么,都写死了。
标题:先拆解,再打分
标题是小红书的命门。
技能 3 xiaohongshu-fire-title 没有直接让 AI「写几个标题」,而是走一套分析、建模、生成、评分的完整流程。
分析阶段,把参考标题拆成 5 个维度:
| 维度 | 识别内容 | 作用 |
|---|---|---|
| 情感触发词 | 震撼、绝了、必看 | 激发用户情绪反应 |
| 身份代入点 | 刚入职、新手、宝妈 | 让目标用户产生共鸣 |
| 权威背书 | 总监、专家、大厂 | 增强可信度 |
| 价值承诺 | 知识库、方法、秘籍 | 明确用户收益 |
| 语言风格 | 口语化、emoji、标点 | 贴近目标用户 |
建模阶段,识别出 5 种结构模式:
模式1: [身份场景] + [情感词] + [权威元素] + [价值载体]
模式2: [建议词] + [目标人群] + [行动] + [价值主体]
模式3: [时间词] + [完成动作] + [价值载体] + [效果]
模式4: [数字] + [价值载体] + [适用场景] + [效果承诺]
模式5: [反差词] + [场景] + [结果] + [情感]生成阶段,按情感冲击型、建议推荐型、成就展示型、权威背书型、实用价值型 5 种类型,每类 2 个,生成 8 到 10 个候选标题。
评分阶段,按主题贴合度 40 分、吸引力 30 分、可读性 20 分、合规性 10 分打分,选出 Top 2。
所有标题严格控制在 20 字以内。
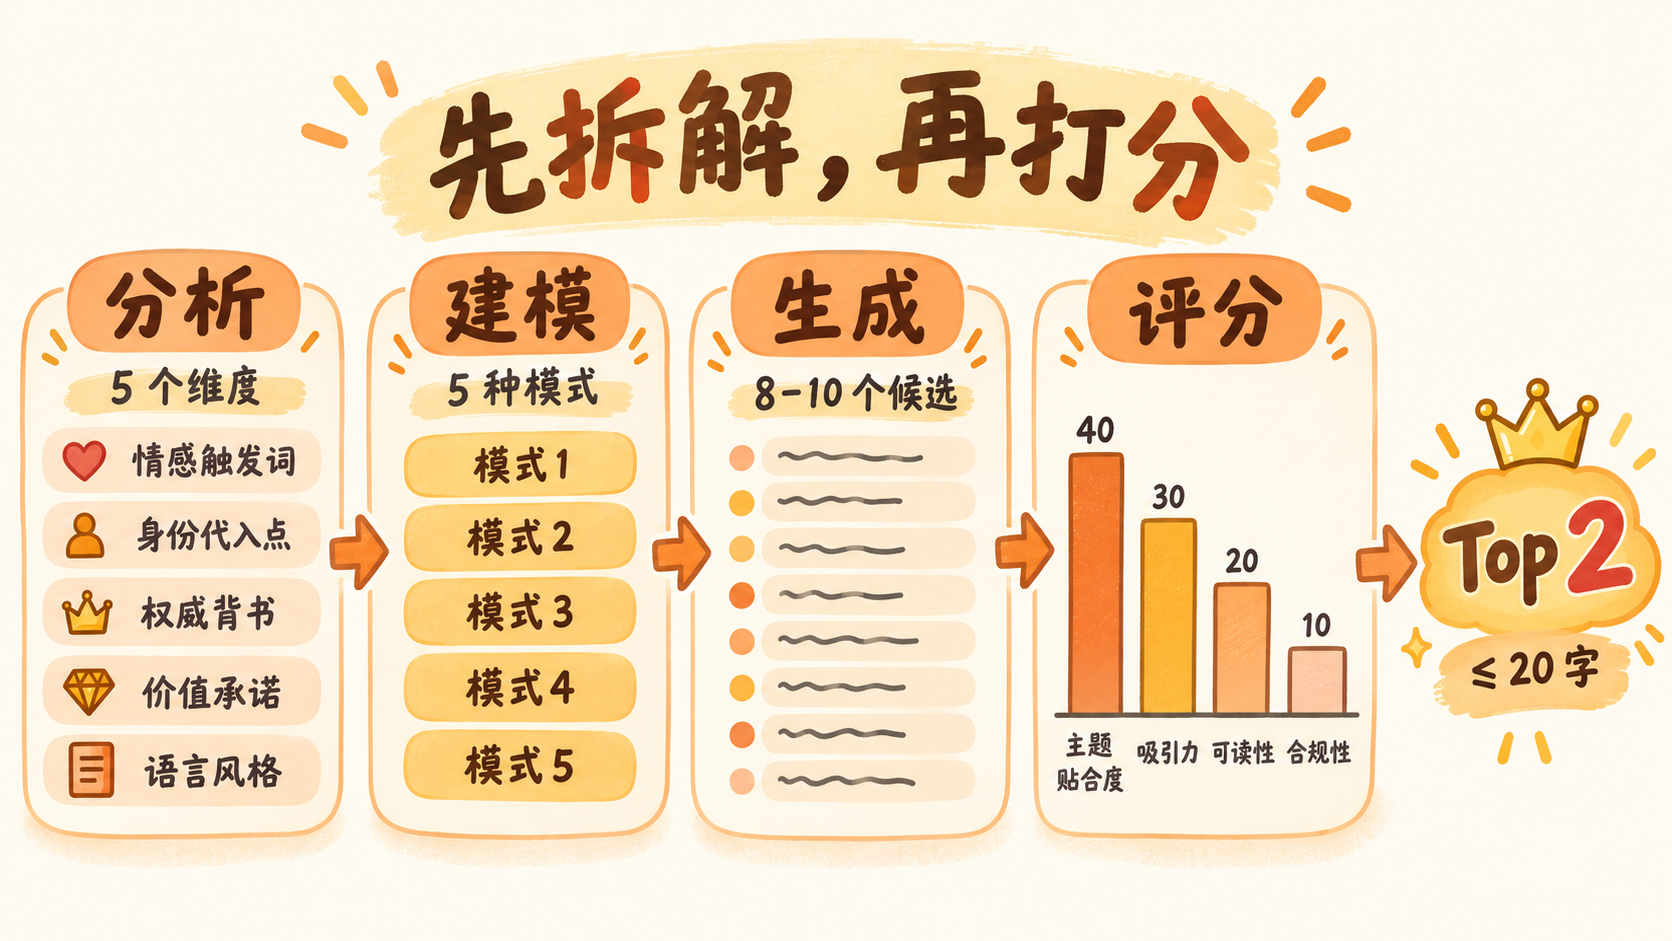
把「震惊体」拆成表格和公式,看着有点好笑。可一旦拆开,模型就不用靠感觉蒙了。
正文:仿写,但不许交提纲
拿到 2 个推荐标题,技能 4 xiaohongshu-fire-content 先对参考爆文做 6 个维度的分析:
- 标题构成方式,吸引点在哪里,用了什么修辞。
- 开头段落设计,是场景描述、问题提出,还是故事引入。
- 正文结构,段落数量、逻辑展开方式(总分总、递进、并列)、信息密度。
- 句式表达,口语化特点、Emoji 使用规律、标点习惯。
- 互动引导,互动点放在哪、用什么方式、怎样号召行动。
- 主题描述,价值点怎么提炼,痛点解决方案怎么呈现。
然后按分析结果写 2 篇完整正文。这里有几条硬约束:
- 2 篇正文分别绑定 2 个推荐标题,一一对应。
- 每篇都必须是完整正文,不允许只给提纲。
- 额外产出 2 条可直接发布的简版摘要,120 到 180 字,口语化,带互动句和建议话题。
- 发布版内容必须是纯文本,禁止任何 Markdown 排版符号。
最后这条看着不起眼,后面会专门说它。
配图:让火山引擎画黑板报
最后一步,技能 5 xiaohongshu-picture 把两篇正文变成配图。
- 调用火山引擎的 doubao-seedream-5.0 图像生成模型。
- API Key 从环境变量
ARK_API_KEY读取。 - 把正文内容注入 prompt 模板里的
XXXXXX占位符,由模型自己把内容拆到多张图里。 - 每篇文章生成 4 张系列图,风格是「黑板报手绘科普信息图」。
- 采用流式生成(
stream=True),支持 2K 分辨率。
prompt 的核心是这样写的:
生成多张系列化黑板报形式手绘科普信息图,采用复古黑板 + 白色彩色粉笔质感呈现,
纯手绘笔触,线条柔和。AI 自动合理拆分全部内容『{正文内容}』至每张图片,
单张信息完整,系列画面风格、色调、构图统一,高清细节,无杂乱文字。
参数上用 sequential_image_generation="auto",让模型自己决定内容怎么分配到几张图里,再用 max_images=4 把上限卡在 4 张。
这两个参数在火山方舟的图片生成 API 文档里叫「组图」。官方的解释是,基于输入的内容生成一组内容关联的图片,需要把 sequential_image_generation 配成 auto。
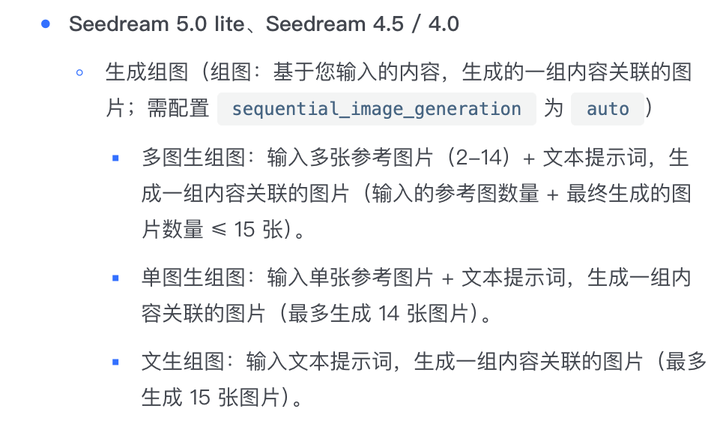
文档里还有两处细节,和这条流水线的写法对得上:
max_images是「最多可生成的图片数量」,取值范围 1 到 15。它是上限,所以这里写 4,图就不会超过 4 张。stream打开以后,每生成一张图就即时返回一张,不用等整组全部画完。单图和组图都支持流式输出。
Seedream 5.0 这一代来得不久。2026 年 2 月 13 日,豆包图像创作模型 Seedream 5.0 Lite 上线火山方舟体验中心,官方介绍里提的是跨模态理解与推理、指令遵循和联网实时检索三项提升。
生成的图片按文章分开存放:
- 文章 1 的配图保存到
{标题目录}/images/article_1/。 - 文章 2 的配图保存到
{标题目录}/images/article_2/。 - 图片路径自动回写到报告版和发布版两份 Markdown 文档。
一次真实运行
说了这么多零件,拿一次真实执行串起来看。
输入就是开头那句飞书消息。
这篇是 IT之家 的报道,《国家互联网应急中心发布 AI 智能体安全应用风险提示》。
步骤 1,原文分析的结果:
主题:AI智能体应用安全风险
核心观点:
  - OpenClaw等AI智能体存在提示词注入攻击风险
  - 误操作可能导致严重后果
  - 第三方插件存在投毒风险
  - 系统安全漏洞修补滞后
目标人群:技术人员、企业IT管理者、关注AI安全的用户
风格:官方通知风格,结构清晰,专业性强
OpenClaw 搭起来的流水线,处理的正好是一篇点名 OpenClaw 安全风险的新闻。选题有点巧。
这篇报道的源头,是国家互联网应急中心 3 月 10 日发布的《关于OpenClaw安全应用的风险提示》。
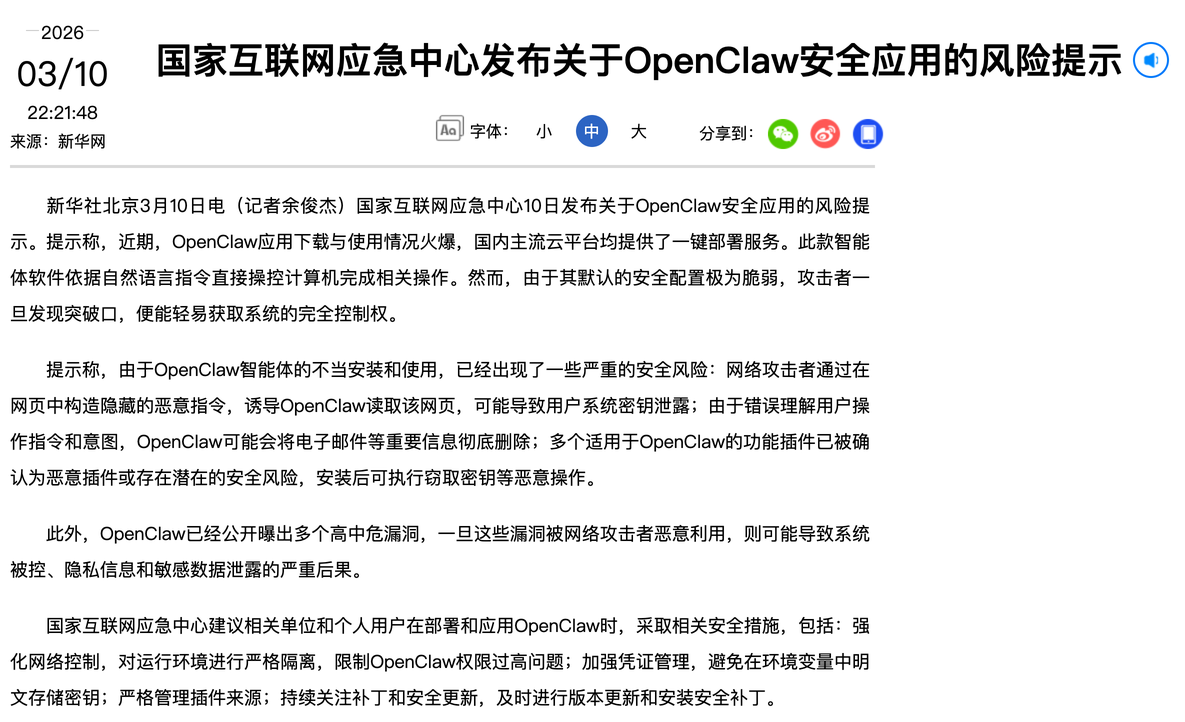
提示里列的风险,和流水线归纳出的四个核心观点基本一一对应。网页里藏的恶意指令可能诱导它泄露系统密钥,错误理解指令可能把电子邮件等重要信息彻底删除,一些功能插件已被确认为恶意插件,软件本身也公开曝出了多个高中危漏洞。
给出的建议有四条,严格隔离运行环境、限制过高权限,避免在环境变量中明文存储密钥,严格管理插件来源,及时打补丁。
拿这份清单对照我自己的流水线,有一处正好撞上。配图技能的 ARK_API_KEY 就是从环境变量读的。OpenClaw 在这条线上还能开终端、启动 Claude CLI,权限不算小。
一篇拿来练手的素材,倒是提醒了我,流水线自己也该做一次安全体检。
步骤 3,标题评分的 Top 2:
| 排名 | 标题 | 评分 | 推荐理由 |
|---|---|---|---|
| 1 | 国家应急中心:AI智能体4大安全隐患 | 92分 | 权威背书+数字化+痛点明确 |
| 2 | 震惊!AI智能体权限过高藏4大风险 | 88分 | 情绪化开头+具体数字+风险警示 |
候选池一共 10 个标题,覆盖了情感冲击、建议推荐、成就展示、权威背书、实用价值五种类型。
步骤 4,正文仿写,节选文章 1 的开头:
姐妹们!这个必须认真看👀
国家应急中心刚发的通报,AI智能体竟然藏着这么多坑!

说实话,我之前也觉得AI工具挺方便的
但看完这个报告,真的出了一身冷汗💦

🚨 隐患1:提示词注入攻击
就像有人偷偷给AI下指令,让它做坏事
你以为它在帮你,其实可能在泄露你的数据
金融、能源这些关键行业最危险!
...
口语化、Emoji 点缀、短句为主,还带着互动引导。一份挺严肃的安全通报,被改写成了小红书用户愿意往下划的样子。
步骤 6,每篇自动生成 4 张黑板报风格的系列配图,一共 8 张,2K 分辨率,风格统一,内容由模型自动分到不同画面里。
最终产出物的目录结构:
2026_docs_public/xiaohongshu/2026-03-11/
└── 国家应急中心:AI智能体4大安全隐患/
    ├── 小红书爆文报告.md      ← 完整分析报告(含5个章节)
    ├── 小红书发布版.md        ← 可直接复制发布的纯文本
    ├── create_picture_1.py   ← 文章1生图脚本
    ├── create_picture_2.py   ← 文章2生图脚本
    └── images/
        ├── article_1/        ← 文章1的4张配图
        └── article_2/        ← 文章2的4张配图
报告版留给自己复盘,发布版直接复制,生图脚本留着,想重画时还能再跑。
几个踩出来的设计
流程图画出来很整齐,真正让它稳下来的,是下面这几处细节。
为什么拆成子代理
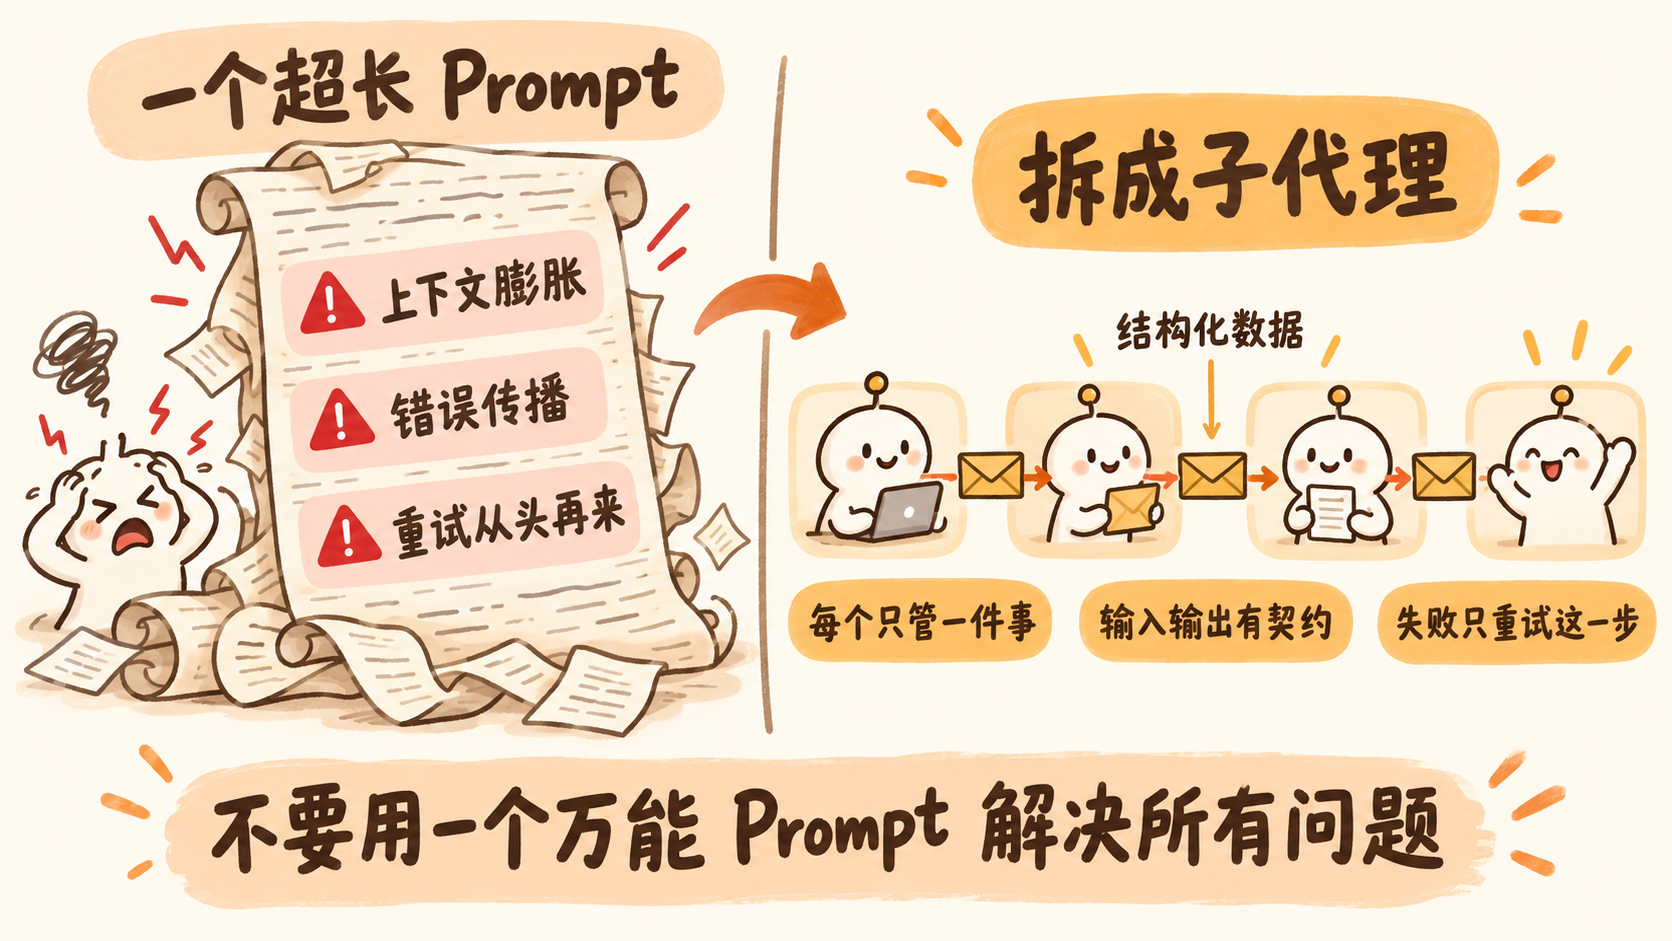
最早的方案很省事,把所有步骤写进一个超长 Prompt,让 Claude 一口气跑完。
跑下来,问题一个接一个:
- 上下文膨胀。原文分析、参考文章、标题生成、正文仿写全堆在一起,token 很快就超出限制。
- 错误传播。标题生成出了错,正文也跟着错,排查起来很难。
- 重试成本高。任何一步出错,都得从头再来。
拆成子代理以后,每个子代理只管一件事,输入输出有明确契约,失败了只重试当前这一步。
发布版必须是纯文本
这个坑是在迭代里踩出来的。
Claude 写东西,默认就爱带 Markdown,加粗、标题、列表一样不落。可小红书的编辑器不渲染 Markdown,粘过去以后,读者看到的是一串原样的 **加粗**。
所以 fire-content 技能里加了一条硬约束:
发布简版摘要必须为纯文本,禁止 Markdown 排版符号(如
**、__、行首#、行首-、行首1.、反引号、[text](url))
光写约束还不够,总控层再做一次二次校验。只要检测到 Markdown 符号,直接返回错误码 CONTENT_BRIEF_MARKDOWN_INVALID,要求重新生成。
目录不能撞车
同一天可能对好几个链接跑流程。推荐标题撞了,或者同一个链接跑了两遍,目录就会冲突。
解决办法是一层层往后加:
目录名 = sanitize(推荐标题1)
如果目录已存在 → 追加时间戳 {HHmmss}
仍然冲突 → 继续追加 _v2/_v3...
还有一个「遗留文件迁移」机制。子代理偶尔会把 Markdown 文件顺手写到项目根目录,Claude 有时就是会这样。流程会自动检测出来,再挪到正确的位置。
为什么不用无头模式
后台静默执行当然更干净。可 Claude CLI 跑的时候会输出大量信息,在终端里能实时看到:
- 正在抓取哪个链接
- 标题候选池的评分过程
- 正文仿写的思考过程
- 图片生成的进度
出问题时,直接看终端就知道卡在哪一步,比翻日志快得多。tmux 还保证了一件事,就算把 iTerm 窗口关了,会话也不会丢。
用到的工具
| 组件 | 技术/工具 | 作用 |
|---|---|---|
| 消息触发 | OpenClaw + 飞书 | 接收用户指令,推送执行结果 |
| 终端管理 | tmux + iTerm + osascript | 可视化执行环境 |
| AI 引擎 | Claude CLI + 自定义技能 | 内容理解、生成、编排 |
| 网页抓取 | Web_Fetch / Chrome / curl / agent-reach | 6层容错抓取策略 |
| 联网检索 | Brave Search / Web Search | 搜索同风格参考文章 |
| 图像生成 | 火山引擎 doubao-seedream-5.0 | 系列化配图生成 |
| 文件管理 | Claude File I/O | Markdown 文档落盘 |
换个平台,也能接着用
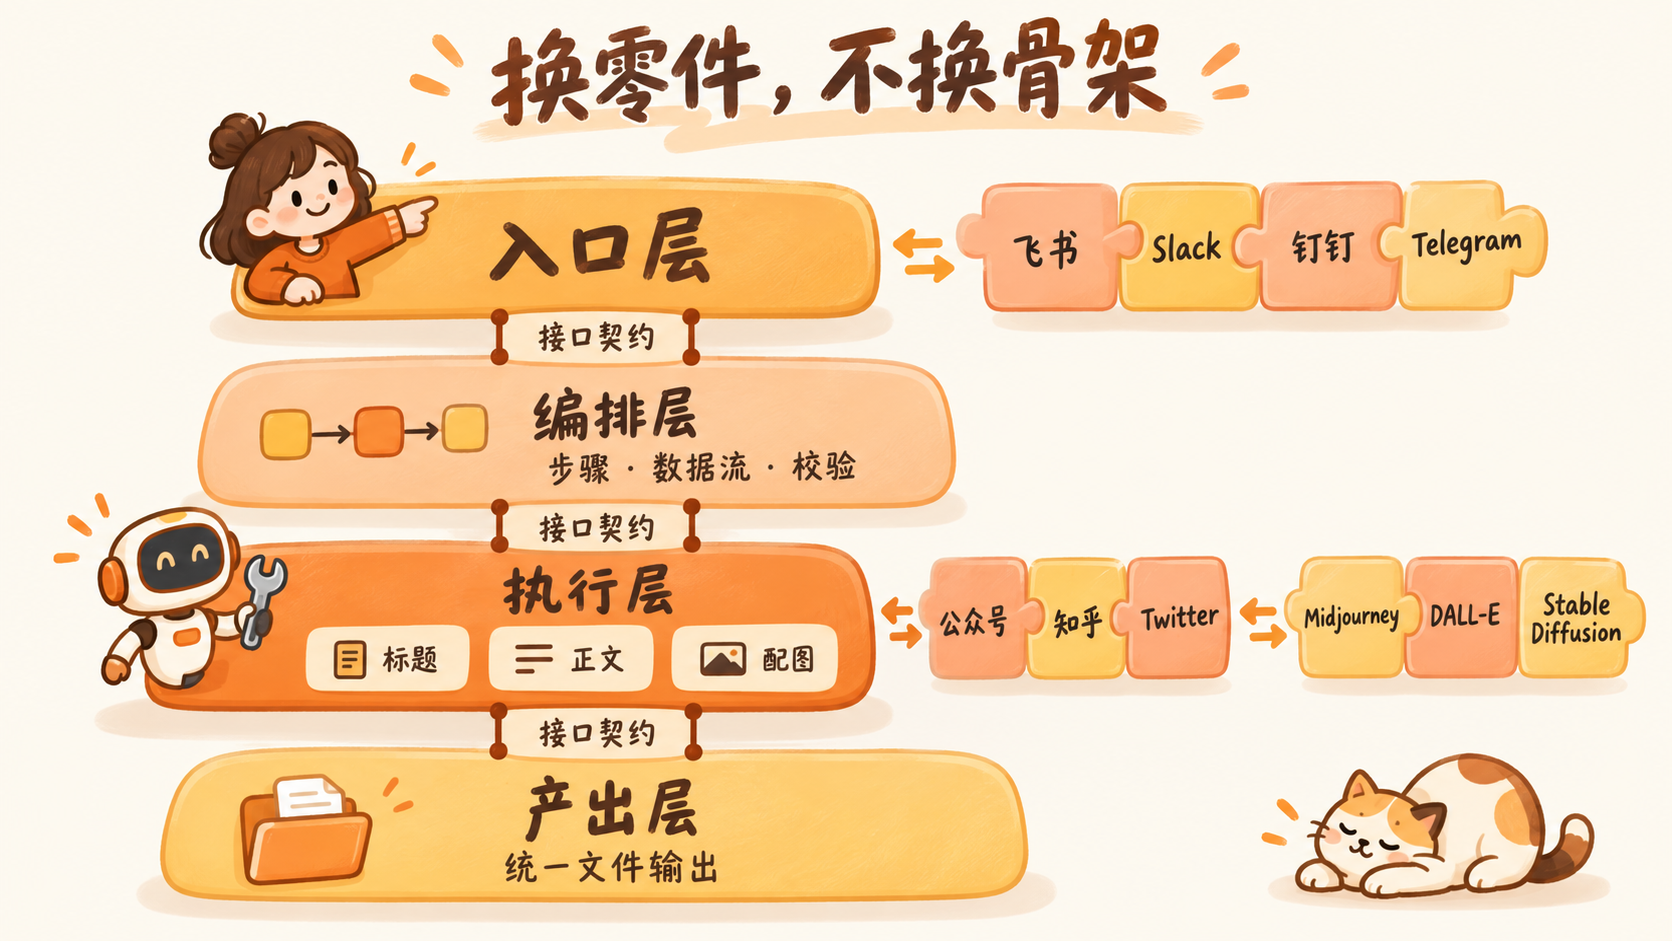
这套东西不只能做小红书。拆开看,它是一种 「AI 技能链编排」 的结构,分四层:
- 入口层,用 OpenClaw 或类似平台接上即时通讯工具,一句自然语言就能触发。
- 编排层,用一个总控技能定义流程步骤、数据流和校验规则。
- 执行层,每个步骤封装成独立技能,以子代理身份运行,靠结构化接口通信。
- 产出层,统一文件输出规范,结果拿来就能用。
想做类似的事情,可以照着换零件:
- 换掉「标题生成」和「正文仿写」,接入自己的内容模板,就能做公众号、知乎、Twitter 这些平台的内容。
- 换掉「图片生成」的 prompt 和 API,就能对接 Midjourney、DALL-E、Stable Diffusion。
- 换掉「飞书触发」,接 Slack、钉钉、Telegram 都行。
前提只有一个,每个技能的接口契约要定义清楚。契约清楚了,换掉哪个模块都不牵连别人。
回到那句飞书消息
现在再看开头那句「小红书流程」加一个链接,它能顺利换回两篇图文,靠的不是哪一句写得特别好的提示词。
这套系统从第一版到稳定版,前后迭代了好几轮。学到最多的一条是:
不要试图用一个万能 Prompt 解决所有问题。
把复杂任务拆成清楚的步骤,每一步都有明确的输入、输出和校验标准。
AI 当然不是万能的。可 AI 加上好的工程设计,能做到很多以前要一个团队才能做完的事。
流水线替我上班,我负责发出那一句话。
补记:AI 接管运营,现在还做不到
这篇写完以后,有几件事要补上。
国家互联网应急中心发风险提示的同一天,2026 年 3 月 10 日,小红书的官方账号「薯管家」也发了一则公告,要治理 AI 托管运营的账号。通过技术手段自动生成内容、发布笔记,并在评论区、私信、群聊里模拟真人互动的,会被重点监测和打击。偶尔用 AI 代写、代发的普通账号,按违规程度警告或限制分发。直接用 AI 托管工具注册、发布、互动,或者主页公开笔记全是 AI 代发的账号,直接封禁。
后面几个月,力度一路往上走。
4 月 27 日,小红书办了首届 AI 治理开放日,第一次把平台对 AI 内容的主张完整摆出来。它鼓励用 AI 把复杂知识讲得更直观,鼓励插画、虚拟角色这类有辨识度的创作,衡量的核心是真实性与原创价值。反对的清单写得也很具体,全自动托管账号、AI 教唆做号、虚构人设、伪造个人经历、批量生产同质化内容,都在里面。所有 AI 参与创作的内容都要主动标识,没标的,平台识别出来以后统一加上 AI 标识贴条。
到 5 月底的上海网络视听创作者大会,小红书 AI 治理团队给出的数字是,截至 2026 年 5 月,累计处置了 18 万篇涉嫌 AI 造假的笔记,对超过 120 万个 AI 托管的矩阵账号做了系统性治理。
另一边,生图模型也没闲着。前面提到的 Seedream 5.0 Lite 是 2 月上线的,到了 7 月 8 日,火山引擎又上线了 Seedream 5.0 Pro 的 API。模型越画越好,平台识别和打击的力气也跟着越用越大。
把这些放在一起,再看我这条流水线,结论挺清楚。
让 AI 全自动接管小红书这类自媒体平台的运营,现阶段做不到。
不是模型不够聪明。内容平台是互联网大厂的地盘,账号、分发、识别、处置,规则都握在平台手里。它要保护的是真实的人和原创的内容,AI 能力每往前走一步,识别和处置也会跟着往前走一步,打击力度只会越来越高。
回头看开头那个「六道手,最好一道都不用我亲自动」的愿望,有一半要收回来。
抓素材、拆结构、打分、起草、出图,这些交给流水线照样省事,它本来也只是把文件放进本地文件夹,没有替我去注册、发布和回评论。可从仿写爆文到真正发出去之间,选题是不是自己的判断,内容有没有自己的经历,这几道手还得我自己来。
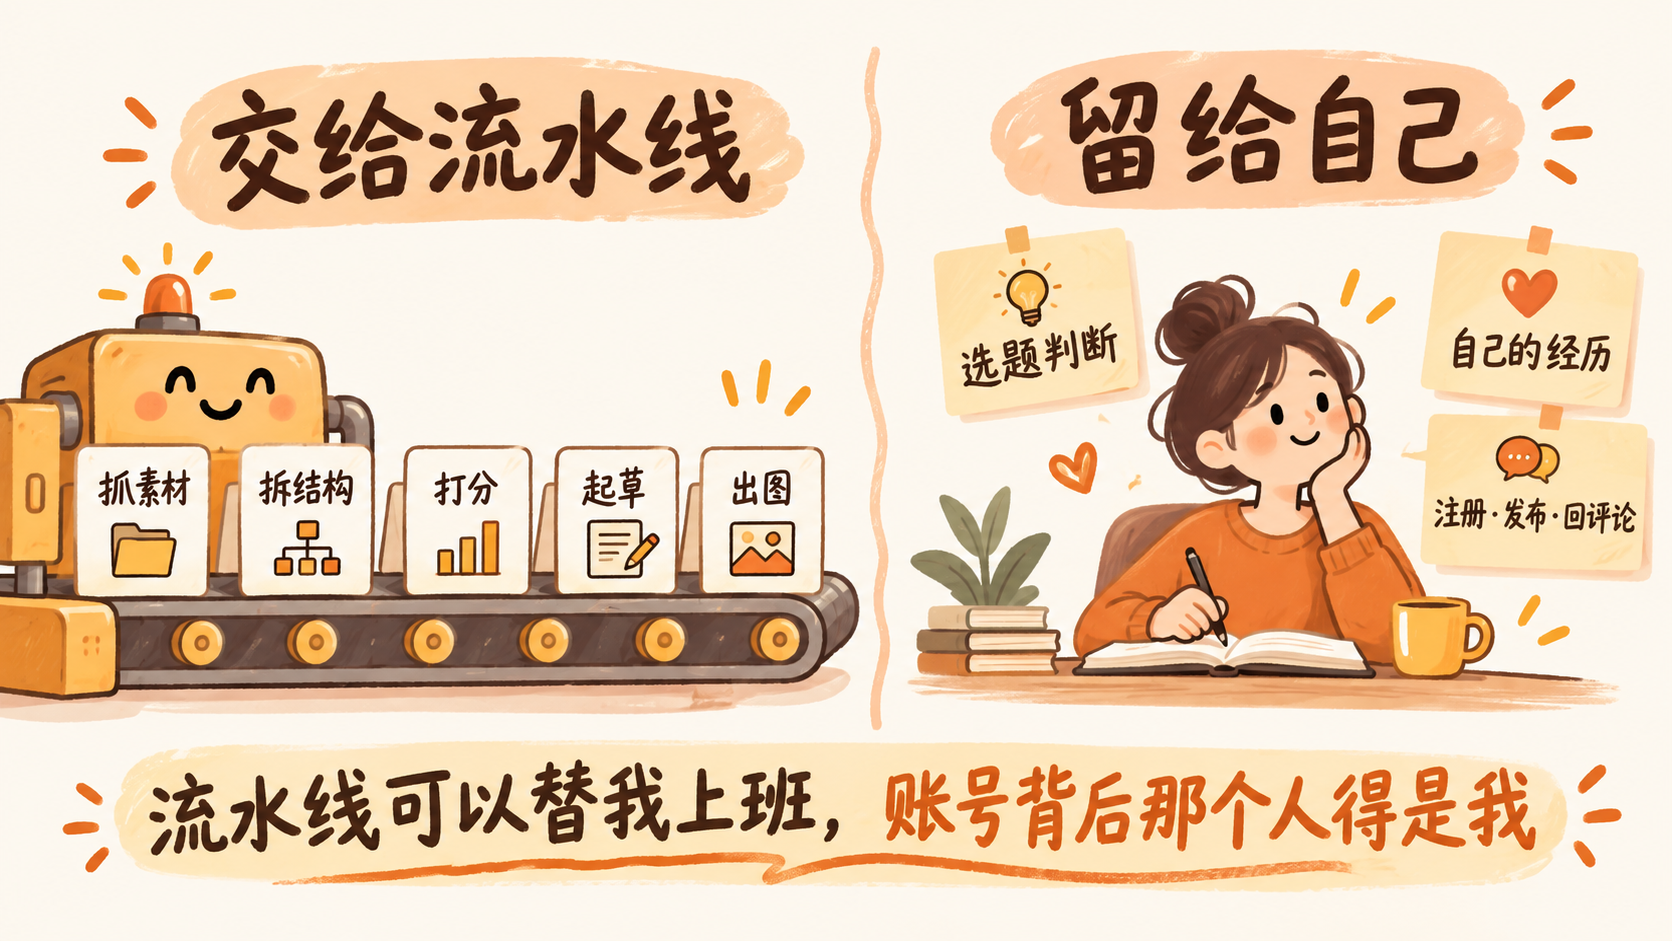
流水线可以替我上班。账号背后那个人,得是我。
参考资料
IT之家:国家互联网应急中心发布 AI 智能体安全应用风险提示
新华网:国家互联网应急中心发布关于OpenClaw安全应用的风险提示
东方财富网:火山引擎 Seedream 5.0 Lite 上线,首次支持联网检索
鸿尘客 Honchic · 把脑洞焊到电路板上